Uma API é confiável quando seus contratos observáveis continuam compreensíveis diante de timeouts, mensagens duplicadas, dependências saturadas e falhas parciais. Chamadas bem-sucedidas são simples; chamadas ambíguas, não. Timeout informa que a resposta não foi recebida no prazo, não que o servidor deixou de alterar dados duráveis. A confiabilidade começa pela identidade da operação, fronteiras dos efeitos e semântica explícita de falhas, não pelo framework [2].
Diferencie requisição concluída de negócio concluído#
Considere a criação de um pedido. O servidor pode validar a requisição e enviá-la a uma fila durável, enquanto a execução de fato ocorre depois. A resposta deve distinguir aceito para processamento de concluído. Uma resposta 202 faz sentido quando representa aceitação assíncrona real; não significa que o trabalho já terminou. Guarde identificador durável da operação, endpoint de status ou mecanismo de eventos para que o cliente descubra o resultado.
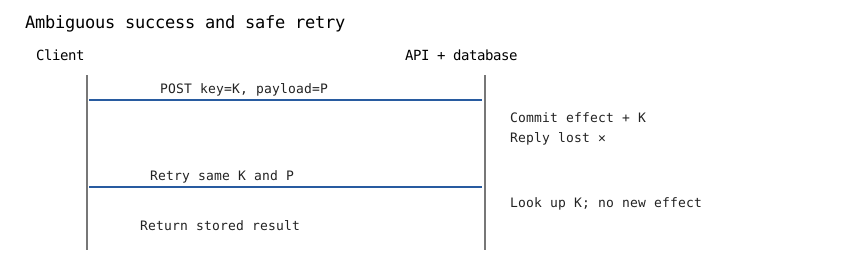
Situação mais delicada: o banco confirma a transação e a conexão cai antes do envio de sucesso. O cliente não pode concluir se o comando ocorreu. Repetir POST com identidade nova pode duplicar uma cobrança. Idempotência é propriedade semântica do efeito, não simplesmente do verbo HTTP.
Idempotência com chave persistida#
O cliente pode enviar uma chave de idempotência única no escopo da operação. O servidor associa chave, identidade da requisição e resultado durável; chamada repetida com a mesma chave e mesmo conteúdo semântico recebe o resultado anterior ou seu status, sem executar outro efeito. Repetição da chave com conteúdo diferente deve ser recusada, não reutilizada silenciosamente. O espaço de chaves deve incluir tenant e tipo da operação para evitar colisões entre usuários.
O registro durável de idempotência e a mutação local devem compartilhar uma fronteira de atomicidade válida. Cache de memória desaparece após reinício e leitura seguida de escrita sofre corrida. Para processador externo de pagamentos, propague chave apropriada ao provedor ou implemente reconciliação: transação do banco local não confirma atomicamente efeitos no serviço remoto.
Timeouts são parcelas do deadline fim a fim#
Considere prazo hipotético de 800 ms para uma chamada. O handler consome 80 ms validando, 120 ms consultando um serviço e 250 ms gravando no banco. Restam 350 ms para outras etapas e resposta, antes de contabilizar overhead de rede e escalonamento. Cada dependência deve observar o prazo restante; atribuir 800 ms a cada serviço pode violar o prazo contratado com o cliente.
Timeout de conexão, leitura, chamada total e cancelamento do trabalho são conceitos distintos. Depois que o cliente desiste, o servidor pode continuar executando se o cancelamento não for propagado ou respeitado. Cancelar também não reverte automaticamente uma transação já confirmada. Decida quais efeitos podem continuar depois da desconexão.
Amplificação de retries e jitter#
Se serviço A chama B, e B chama C, repetir em todas as camadas multiplica tentativas. Com até três tentativas totais por camada, uma operação pode provocar até 3×3 = 9 tentativas de chamadas downstream em duas camadas com retries independentes, mesmo sem outros fan-outs. Falha em C gera tráfego adicional justamente quando C está menos capaz de responder [2].
Repita somente quando o erro provavelmente é transitório e a operação pode ser executada de novo com segurança. Use backoff exponencial limitado com jitter aleatório e deadline geral. Jitter diminui ondas sincronizadas; não transforma comando não idempotente em comando idempotente. Limites de repetição, circuit breakers e rate limiting devem proteger o serviço de ciclos infinitos de sobrecarga [2][3].
def espera_maxima_ms(tentativa, base=100, limite=1600):
    if tentativa < 0 or base <= 0 or limite <= 0:
        raise ValueError("parametros invalidos")
    return min(limite, base * (2 ** tentativa))

def status_repetivel(status, operacao_idempotente):
    transitorio = status in (429, 502, 503, 504)
    return transitorio and operacao_idempotente

assert [espera_maxima_ms(i) for i in range(6)] == [100,200,400,800,1600,1600]
assert status_repetivel(503, True)
assert not status_repetivel(503, False)
assert not status_repetivel(400, True)
A função calcula envelope máximo de espera, não jitter aleatório. Um cliente real sorteia atraso segundo regra escolhida e respeita Retry-After e prazo restante. Exceções de transporte exigem tratamento separado dos status HTTP. O status 429 sinaliza limitação de taxa conforme contrato [4].
Backpressure, rejeição e trabalho limitado#
A taxa de admissão não pode superar a capacidade sustentada de conclusão indefinidamente sem criar fila. Se chegam λ tarefas/s e trabalhadores concluem μ tarefas/s com λ>μ, uma fila ilimitada cresce aproximadamente (λ−μ) por segundo até que alguma condição mude. Mil requisições/s aceitas com serviço concluindo 700/s geram aproximadamente 18.000 pendências em um minuto, ignorando cancelamentos e retries. Responder rapidamente 503/429 sob sobrecarga deliberada pode ser melhor que aceitar trabalho cujo prazo não será cumprido [3].
Backpressure informa o produtor que deve reduzir ou parar; load shedding rejeita trabalho para proteger o serviço; limite de concorrência controla operações simultâneas. Ações diferentes sobre variáveis diferentes. Cota de 100 RPS não garante segurança quando cada requisição passa a levar 20 segundos em vez de 20 milissegundos.
Contratos de erro legíveis por máquinas#
A RFC 9457 define problema HTTP em JSON com propriedades como type, title, status, detail e instance [1]. O corpo faz parte do contrato: clientes devem depender de identificadores de erro documentados e estáveis, não interpretar frases em português ou inglês. Não divulgue stack traces internos ou segredos. Identificador de correlação pode auxiliar observabilidade, com mensagem e remediação adequadas e sem expor implementação sensível.
{
  "type": "https://example.org/problems/upstream-unavailable",
  "title": "Service temporarily unavailable",
  "status": 503,
  "detail": "Retry later using the same operation identifier."
}
O URL de tipo é ilustrativo; em produção deve haver documentação estável. Mantenha status HTTP, content type e resposta coerentes. Formato padrão de erro não determina se uma operação pode ser repetida com segurança.
Injeção de falhas e garantias observáveis#
Crie matriz de teste: falha antes de transação; queda após commit mas antes da resposta; chaves duplicadas concorrentes; timeout downstream com resultado desconhecido; fila cheia; banco saturado; proxy retornando erro enquanto aplicação ainda executa. Verifique estado durável, efeitos de negócio duplicados, percentis de latência e tempo de recuperação, não apenas status HTTP.
| Falha | Decisão necessária |
|---|---|
| Timeout após gravação | Como obter resultado por ID? |
| POST concorrente repetido | Qual chave única impede efeito duplo? |
| Dependência saturada | Qual camada rejeita e qual repete? |
| Falha regional parcial | Quais operações suportam failover? |
| Dependência envia erro malformado | Como classificar incerteza do resultado? |
Capítulos relacionados: Filas e idempotência tratam efeitos atrasados; rate limiting define admissão; redes explica ambiguidades de transporte.
Exercícios e verificação#
- Com prazo inicial de 500 ms e 200 ms já consumidos, por que uma chamada nova não pode receber 500 ms independentes?
- Calcule tentativas máximas de três camadas com duas tentativas totais: 2³ = 8, sem encerramento antecipado. Por que essa política é ruim?
- Descreva transação que insere registro de operação sob chave única e aplica alteração local. Mostre por que dois clientes concorrentes não confirmam o mesmo efeito.
- Compare rejeição explícita e buffer ilimitado quando λ>μ durante dez minutos; estime fila e prazo observado pelo usuário.
- Mostre por que o classificador acima é necessário, mas insuficiente: ambiguidade de transporte, Retry-After, semântica do efeito e identidade estão fora da função.