Um banco relacional não é apenas um conjunto de tabelas representadas por dicionários. É um mecanismo de armazenamento que mantém páginas, metadados de transações, índices e log de recuperação sob concorrência. Conhecer essas estruturas explica por que consultas indexadas podem ser lentas, por que atualizações produzem mais E/S que o esperado e como mudanças confirmadas sobrevivem a quedas. PostgreSQL será a referência concreta; outros bancos diferem nos detalhes [1]. O capítulo de descritores e fsync distingue visibilidade de durabilidade, enquanto journaling de sistemas de arquivos explica consistência de metadados; WAL adiciona ordenação e recuperação de transações em camada superior.
Páginas físicas e identidade de tuplas#
PostgreSQL organiza relações persistidas em arquivos com páginas de tamanho fixo. O tamanho padrão nas configurações comuns é 8 KiB, embora outra compilação possa usar valor diferente. Uma página possui cabeçalho, identificadores de itens, conteúdo das tuplas e espaço livre. Os identificadores apontam para tuplas internas. Um identificador físico de tupla (CTID) combina número de página e deslocamento do item; não é chave primária imutável da aplicação [1].
Uma linha SQL é uma entidade lógica. Atualizações podem modificar sua representação física, e múltiplas versões físicas podem representar a mesma linha lógica. Tratar CTID como identificador permanente de negócio é incorreto. A chave primária é uma identidade visível à aplicação e garantida por restrição; ela não tem as mesmas propriedades do endereço físico.
MVCC e visibilidade entre versões#
O controle multiversão de concorrência (MVCC) permite snapshots nos quais transações distintas observam versões confirmadas diferentes. Tuplas do PostgreSQL carregam identidade de transações e metadados usados na avaliação de visibilidade, conforme snapshot e estado das transações. Um UPDATE costuma criar versão mais recente em vez de sobrescrever a única representação. Leitores de snapshot antigo ainda podem precisar da versão anterior, enquanto transações recentes usam aquela permitida para seu snapshot [1].
Logo, uma varredura física pode encontrar versões invisíveis à transação consultante. O vacuum pode recuperar espaço ocupado por versões obsoletas quando nenhum snapshot relevante necessita delas. Transações longas podem impedir a limpeza. Há distinção fundamental entre versão física de uma linha numa página e linha logicamente visível ao resultado SQL.
Como B-trees reduzem a busca#
O índice B-tree mantém chaves separadoras ordenadas para conduzir buscas pelas páginas internas até entradas das folhas. Diferentemente da árvore binária com até dois filhos, uma B-tree de banco usa vários ponteiros por página e reduz acessos físicos. Numa árvore idealizada com ramificação efetiva b e N registros, a profundidade cresce aproximadamente como log_b(N); custos reais dependem de preenchimento, caches e organização do índice. A implementação do PostgreSQL trata divisões de páginas e atualizações concorrentes [2].
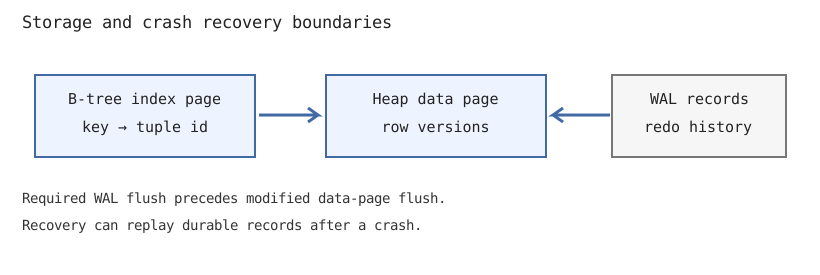
Uma entrada de índice costuma guiar o executor até posição de tupla no heap. Um index scan pode exigir leituras adicionais do heap e checagem de visibilidade MVCC. Um index-only scan evita parte dessas leituras quando o índice contém dados necessários e o mapa de visibilidade informa que a página satisfaz o requisito de visibilidade. Selecionar somente colunas indexadas não basta para assegurar ausência de leituras do heap [4].
Divisões de página e amplificação de escrita#
Se a folha não possui espaço para nova entrada, a B-tree pode dividir a página e atualizar ligação no nó pai. Divisões podem propagar para níveis acima; a raiz pode dividir e elevar a altura total [2]. Novas entradas, páginas alteradas e registros de recuperação geram amplificação de escrita em relação ao INSERT lógico. Chaves aleatoriamente distribuídas podem ter localidade e frequência de splits diferentes de chaves sequenciais. Um filtro pouco seletivo ainda pode favorecer varredura sequencial, pois buscar muitas páginas do heap aleatoriamente custa mais que percorrer a tabela.
Um índice composto (tenant_id, created_at) pode atender bem consultas que fixam tenant e filtram período. Isso não assegura eficiência equivalente ao consultar somente created_at: a ordenação começa pelo prefixo da chave. Analise plano de execução, estimativas de linhas e heap fetches antes de atribuir custo apenas à existência de índice.
Invariante de ordenação do WAL#
O write-ahead log (WAL) usa o princípio registrar a mudança antes de tornar durável a página modificada. Mais precisamente, os registros WAL necessários devem atingir armazenamento durável antes da gravação definitiva da página correspondente. Em queda, o motor pode reproduzir registros persistidos e reaplicar modificações que ainda não estão nos arquivos de dados [3].
Assim o banco pode confirmar transação sem forçar imediatamente todas as páginas alteradas de heap e índice. Porém WAL sozinho não promete durabilidade de resposta ao cliente em todas as configurações: políticas de synchronous commit, fsync e confirmação por réplicas influenciam o que foi persistido e quais falhas são toleradas. O hardware também precisa cumprir as solicitações de flush. Log de recuperação não substitui backup nem recuperação de desastre regional.
Modelo reprodutível de capacidade de página#
def capacidade_pagina(bytes_pagina, bytes_cabecalho, bytes_item, bytes_tupla):
    if bytes_pagina <= 0 or min(bytes_cabecalho, bytes_item, bytes_tupla) <= 0:
        raise ValueError("tamanhos devem ser positivos")
    if bytes_cabecalho >= bytes_pagina:
        return 0
    return (bytes_pagina - bytes_cabecalho) // (bytes_item + bytes_tupla)

assert capacidade_pagina(8192, 24, 4, 96) == 81
assert capacidade_pagina(4096, 24, 4, 96) == 40

def niveis_ideais_btree(registros, ramificacao):
    if registros < 0 or ramificacao < 2:
        raise ValueError("valores invalidos")
    folhas, niveis = max(1, registros), 0
    while folhas > 1:
        folhas = (folhas + ramificacao - 1) // ramificacao
        niveis += 1
    return niveis

assert niveis_ideais_btree(1000000, 100) == 3
Esse é um modelo aritmético ilustrativo, não o alocador de tuplas do PostgreSQL. Páginas reais incluem cabeçalhos de tamanho variável, ponteiros, alinhamento, bitmap de nulos, margens livres e eventualmente valores TOAST. A função de níveis aproxima agrupamentos ideais, não prevê altura exata de uma B-tree real.
Linha do tempo de queda e recuperação#
Imagine transação T que altera página e cria registro WAL correspondente. O WAL é gravado de forma durável, mas a página suja continua na memória. Uma queda apaga a página em memória. Ao reiniciar, a recuperação lê o log persistido e pode refazer a modificação ausente. Se a página já foi escrita com segurança, o mecanismo de redo precisa evitar aplicar a mesma alteração erroneamente duas vezes, usando posições de log e metadados apropriados [3].
Agora inverta a ordem: se a página alterada atingir armazenamento enquanto o registro necessário do log não existir, a recuperação ficará sem histórico suficiente para restabelecer estado consistente. Por isso a ordem é requisito de correção, não preferência de desempenho.
Falhas, ajustes e fronteiras de arquitetura#
| Sintoma | Hipótese | Verificação |
|---|---|---|
| Consulta indexada fica lenta | Heap fetches ou estatísticas desatualizadas | Plano, buffers e estimativas |
| Espaço cresce após UPDATE | Versões MVCC antigas e índices | Vacuum e churn |
| INSERT fica irregular | Splits, flush de WAL ou contenção | Métricas de log, E/S e locks |
| Réplica atrasa | Atraso de envio ou replay | Posição de replay e lag |
| Queda perde escrita confirmada | Política de persistência ou armazenamento | Flush e modelo de falha |
Um banco transacional compartilhado possui garantias distintas das de um sistema global distribuído. WAL pode permitir recuperar o estado de um motor, mas não constitui consenso entre réplicas. Além disso, MVCC e isolamento são conceitos distintos: multiversão pode implementar níveis de isolamento diferentes sem implicar serializabilidade automaticamente.
Capítulos relacionados: Consistência de bancos explica isolamento e snapshots MVCC. Planejamento SQL explica escolhas entre index scan, leituras do heap e varredura sequencial. Consenso trata outro problema de ordem e falhas entre nós.
Exercícios e verificação#
- Recalcule capacidade ideal com cabeçalho 24 B, ponteiro 4 B e tupla 96 B numa página de 8.192 B. Explique o que foi ignorado.
- Explique por que um índice que contém todas as colunas selecionadas ainda pode precisar consultar visibilidade no heap.
- Monte cronograma de queda com WAL persistido antes da página de dados e mostre o que será reproduzido.
- Mostre como split de folha pode atingir a raiz e aumentar a altura da árvore.
- Numa tabela com milhões de linhas e índice por tenant, compare consulta por tenant, varredura total e consulta por faixa num índice composto; declare hipóteses de seletividade.