Reconectar um consumidor RabbitMQ após reinício do nó broker é diferente de reconectar após queda apenas da conexão enquanto o broker permanece ativo. Fila apenas em memória pode desaparecer quando o nó reinicia. Mesmo uma fila durável não torna mensagens transitórias duráveis. Esta oficina reinicia um broker de nó único real no GitHub Actions, preservando container e armazenamento, e verifica que mensagem persistente confirmada pelo publicador continua disponível [1][2].
Três decisões de durabilidade com contratos distintos#
RabbitMQ separa durabilidade da fila, modo de entrega da mensagem e confirmação da publicação. Uma fila durável registra metadados para recuperação após restart. Uma mensagem persistente exige retenção durante reinícios conforme garantia do armazenamento. Publisher confirms informam quando broker assumiu responsabilidade segundo tipo de fila e mensagem. Usar apenas uma ou duas opções não fornece o mesmo contrato que utilizá-las juntas [1][2].
O teste usa uma fila classic de nó único com mensagem delivery_mode=2, fila declarada durable=True e canal com confirm_delivery(). O produtor encerra a conexão depois da publicação confirmada. Não supomos que uma fila classic seja replicada: em RabbitMQ 4, classic queues não são estruturas replicadas entre nós [3].
Requisitos e fronteira da falha#
O sistema precisa manter uma mensagem confirmada ainda não consumida enquanto processo broker para e reinicia no mesmo container. Depois do restart, o teste cria conexão nova, verifica fila e mensagem original, envia ACK e remove fila temporária.
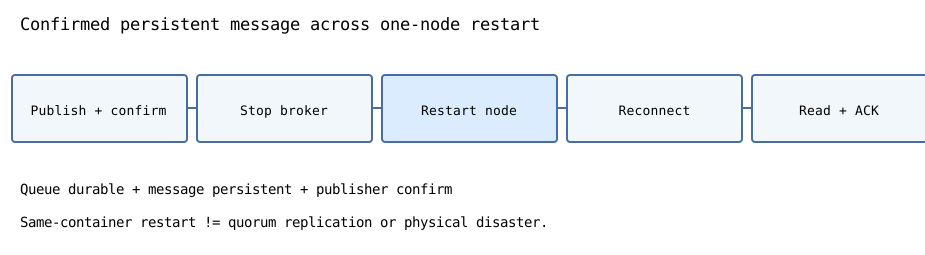
O modelo de falha é delimitado: Docker reinicia o container já existente, preservando seu armazenamento gravável. O teste não remove diretório de dados, muda nó responsável, corrompe disco nem provoca perda de quorum. O resultado comprova recuperação por restart de processo/container nesse runner, não desastre completo ou eleição de líder RabbitMQ.
Teste integrado e reprodução#
O script scripts/verify_rabbitmq_restart.py executa os passos abaixo e obtém ID do container por contexto do job GitHub Actions. O build o executa em etapa independente depois dos demais testes, evitando interromper integrações que dependem do broker.
1. Conecte e declare fila classic durável com nome isolado.
2. Habilite publisher confirms e envie mensagem persistente.
3. Feche conexão publicadora e reinicie mesmo container via Docker.
4. Aguarde broker aceitar conexão nova, respeitando timeout total.
5. Confira fila e identidade exata da mensagem, envie ACK e limpe a fila.
É possível executar localmente com RABBITMQ_CONTAINER_ID de container descartável e RABBITMQ_HOST do endpoint AMQP. É necessário acesso a Docker. Nunca execute contra container de produção compartilhado: o restart intencional interromperia clientes.
Publisher confirm não equivale ao ACK do consumidor#
A confirmação ao produtor diz que o broker aceitou publicação nas condições documentadas. O basic_ack manual do consumidor informa que aquela entrega já pode ser descartada. Nenhum dos dois comprova transação em banco de outro sistema nem cobrança financeira. Se consumidor confirma efeito local e perde ACK, broker poderá enviar mensagem novamente; o laboratório de inbox testa justamente essa situação.
Fluxo durável exige identidade estável de evento, e consumidor deve deduplicar o efeito na mesma transação autoritativa quando possível. Persistência do broker protege mensagem aguardando processamento; idempotência da inbox protege aplicação contra repetição de mesma intenção. São propriedades complementares [2].
Modelo mínimo de configuração, não simulação de broker#
Defina condição necessária para uma configuração ser elegível ao teste de restart proposto. O booleano não demonstra segurança real; só confere decisões necessárias.
def configuracao_restart(fila_duravel, mensagem_persistente, confirmada):
    return bool(fila_duravel and mensagem_persistente and confirmada)

assert configuracao_restart(True, True, True)
assert not configuracao_restart(True, False, True)
assert not configuracao_restart(False, True, True)
assert not configuracao_restart(True, True, False)
Broker verdadeiro possui semântica de filesystem, disco, recursos e falhas não representada nessa função. Por isso o repositório também reinicia container real e lê mensagem original. Passar por checklist não substitui teste de integração.
Restart não é failover com quorum#
Quorum queues usam estado replicado com Raft. Uma fila quorum de três membros normalmente continua disponível após perda de um membro, se maioria restante puder se comunicar; perder maioria impede funcionamento normal. Escritas confirmadas seguem esse modelo de durabilidade replicada [3]. Reiniciar nó único não demonstra eleição de líder ou maioria, mesmo se repetir teste muitas vezes.
Para verificar quorum de verdade, inicie cluster com vários nós, crie fila quorum com membros apropriados, confirme publicações, interrompa líder e observe eleição e leitura de mensagens após reconectar. Depois retire a maioria e confirme indisponibilidade esperada. Registre topologia dos membros e volumes antes de afirmar tolerância a perda de nó.
Tempo de recuperação, detecção e retries#
Um nó reiniciado precisa inicializar antes de aceitar conexões TCP e canais AMQP. Clientes precisam lidar com falhas de conexão mediante retries limitados, deadlines e jitter. O script aguarda conexão nova até prazo máximo; tentativa única pode falhar mesmo que recuperação durável funcione alguns segundos depois.
Recuperação pode demorar por índices grandes, redelivery de mensagens, inicialização do processo, disco e DNS. Um teste que observa apenas abertura da porta não prova que conteúdo da fila voltou; obter corpo e ID exatos torna a verificação mais forte.
Falhas e consequências operacionais#
| Falha | Possível resultado | Evidência |
|---|---|---|
| Consumidor cai sem ACK | Mensagem reenfileirada | Teste de redelivery |
| Nó reinicia com fila e mensagem persistentes confirmadas | Mensagem deve permanecer no modelo | Recuperar após restart |
| Container excluído e dados apagados | Estado local pode sumir | Volume externo e teste de restore |
| Follower de quorum cai | Maioria pode prosseguir | Experimento multinó |
| Quorum perde maioria | Fila indisponível | Teste de partição |
| PSP confirma operação, depois timeout | Broker não comprova efeito remoto | Idempotência e conciliação |
Broker pode voltar enquanto workers continuam atrasados pelo backlog. Meça RTO, idade máxima de evento e replay separadamente. Restart que recupera em 15 segundos não implica todos os webhooks concluírem em 15 segundos.
Exercícios e verificação#
- Qual mecanismo falta quando fila durável recebe mensagens transitórias sem confirms?
- Diferencie conexão AMQP restabelecida de recuperação efetiva da mensagem original.
- Adapte teste para excluir/recriar container usando volume persistente; especifique configuração necessária.
- Desenhe cluster de três nós que interrompe líder, verifica eleição e preservação de mensagens.
- Por que inbox idempotente é necessária mesmo com todos os requisitos de durabilidade do broker satisfeitos?
Capítulos relacionados: RabbitMQ redelivery, mensageria, injeção de falhas e consenso fundamentam garantias [1][2][3].