System Design transforma requisitos de produto em sistemas cujo comportamento observável, consumo de recursos e resposta a falhas podem ser explicados e testados. Um projeto defensável não é desenho de serviços de nuvem populares. Ele começa com carga e invariantes críticos, depois define contratos, dados, componentes, decisões, recuperação e validação por métricas. Objetivos de nível de serviço (SLOs) tornam confiabilidade uma decisão mensurável [1].
Etapa 1: defina o que o sistema deve fazer#
Esclareça primeiro requisitos funcionais: quem cria um objeto, quem lê, como ocorre atualização, se exclusão é permitida e se clientes precisam de resposta síncrona. Para um serviço hipotético de notas, suponha usuários autenticados criando notas privadas, recuperando as próprias notas por identificador e listando-as em ordem cronológica inversa. Edição, colaboração, busca e compartilhamento público ficam explicitamente fora da primeira versão.
Estabeleça também requisitos negativos e invariantes. Um usuário não pode consultar nota privada alheia; criação anunciada como concluída precisa estar duravelmente persistida; repetir uma operação com a mesma chave idempotente não pode criar duas notas. Essas condições diferem de escolher PostgreSQL ou Redis. Documente-as antes de otimizar.
Etapa 2: transforme qualidades em números#
Defina SLI de disponibilidade como requisições elegíveis bem-sucedidas divididas pelo total elegível numa janela. Considere meta hipotética de 99,9% de sucesso mensal, latência p95 do servidor inferior a 250 ms em leituras e recuperação após perder uma instância da aplicação. Isso não representa garantia de sistema existente. O orçamento de erros de 0,1% é uma fração tolerada de requisições elegíveis, não autorização para perder dados de usuários [1].
Segurança envolve autenticação, autorização, classificação de dados e retenção. Durabilidade diz respeito a registros confirmados sobreviverem a falhas especificadas; não equivale a disponibilidade da API. Uma leitura rápida continua errada se atravessa fronteira de tenant. Decida exigências de consistência, como read-your-writes após nota confirmada, antes de escolher replicação assíncrona.
Etapa 3: dimensione com unidades#
Suponha 8,64 milhões de requisições/dia, 90% de leituras, pico dez vezes a média e resposta média de 2 KiB. São hipóteses de cenário para demonstrar método. A média é 100 requisições/s; o pico suposto é 1.000/s; leituras no pico são 900/s. Tráfego bruto de respostas no pico é aproximadamente 1,95 MiB/s, sem overhead. Se 10% das requisições diárias criam registros com payload bruto médio de 1 KiB, o crescimento bruto anual é cerca de 301 GiB, antes de réplicas, índices, logs e backups.
from math import ceil

def estimar(requisicoes_dia, multiplicador_pico, rps_seguro_instancia):
    if requisicoes_dia < 0 or multiplicador_pico <= 0 or rps_seguro_instancia <= 0:
        raise ValueError("parametros de capacidade invalidos")
    media_rps = requisicoes_dia / 86400
    pico_rps = media_rps * multiplicador_pico
    minimo = ceil(pico_rps / rps_seguro_instancia)
    # Reserva N+1 para uma falha de instancia de aplicacao identica.
    provisionadas = minimo + 1
    return media_rps, pico_rps, minimo, provisionadas

media, pico, minimo, maquinas = estimar(8_640_000, 10, 300)
assert (media, pico, minimo, maquinas) == (100, 1000, 4, 5)
assert (maquinas - 1) * 300 >= pico
assert 0.001 * 8_640_000 == 8640
A capacidade de 300 RPS por instância precisa vir de teste de carga com a mistura real de operações em latência e utilização aceitáveis, não de suposição sobre processadores. N+1 só considera a perda de uma instância; não garante sobreviver à falha do banco compartilhado, rede ou zona inteira. Cache de leitura reduz pressão, mas introduz invalidação e consistência.
Etapa 4: contratos antes de componentes#
Defina identidade de operação e payload. Uma interface proposta usa POST /v1/notes com chave de idempotência e corpo contendo texto. Criação duravelmente confirmada retorna 201 com ID estável. GET /v1/notes/{id} devolve 200 somente ao proprietário autenticado; a política de segurança pode retornar 404 para evitar revelar identificador alheio. GET /v1/notes?limit=...&cursor=... retorna página limitada e continuação.
O contrato especifica tamanho máximo do corpo, validação, autorização, deadlines, erros, rate limits, repetição de chamadas e versionamento. Defina o significado de 201: criação confirmada na fonte autoritativa. Retornar 201 para operação apenas enfileirada confunde aceitação com conclusão; processamento assíncrono real pode responder 202 e expor recurso de status, conforme semântica [2].
Etapa 5: menor arquitetura que atende#
Comece com clientes → entrada HTTPS/load balancer → API de notas stateless → banco transacional primário. Só acrescente cache quando houver gargalo comprovado e política viável de invalidação. Adicione outbox e consumidor quando houver necessidade assíncrona real, como indexação ou notificações. Transformar o serviço pequeno em seis microsserviços introduz fronteiras de rede sem resolver problema medido.
Na criação, autorize o usuário, valide conteúdo, grave nota e chave de idempotência na mesma transação, confirme e só então devolva 201. O banco impõe unicidade sobre proprietário+chave da operação, impedindo duplicatas sob retries simultâneos. Uma chave repetida deve permitir recuperar a resposta anterior; a mesma chave com payload diferente exige conflito definido. Mapa local de processo falha após restart e entre instâncias.
Etapa 6: escolha o banco pelos acessos#
A carga requer lookup por ID, listagem por proprietário ordenada por tempo e criação consistente. Banco relacional com índice composto (owner_id, created_at, note_id) é uma opção inicial plausível. A sequência de colunas permite filtro de proprietário e ordenação estável; confirme com plano de execução e requisitos de retenção. Paginar apenas por timestamp pode causar ambiguidades quando duas notas têm mesmo instante: use (created_at, note_id) no cursor.
Banco de documentos ou chave-valor não é automaticamente errado. A escolha depende de transações, tipos de consultas, consistência e capacidade operacional da equipe. Réplica de leitura pode reduzir carga no primário, mas não garantir read-your-writes sob atraso. Dimensione linhas, índices, WAL, backups e réplicas separadamente do payload bruto.
Etapa 7: falhas e evolução do desenho#
Timeout após commit representa resultado ambíguo: o cliente não recebeu confirmação, mas a escrita pode ter ocorrido. Idempotência trata a ambiguidade. Se o banco cair, a API precisa falhar no deadline ou oferecer degradação explícita; filas ilimitadas podem transformar pane breve em backlog prolongado. Retentativas em múltiplas camadas podem amplificar a sobrecarga [2].
| Falha ou crescimento | Tratamento inicial | Custo/risco |
|---|---|---|
| Instância API indisponível | Health checks e reserva de capacidade | Dependências compartilhadas permanecem |
| Banco primário fora | Falha controlada nas escritas e recuperação documentada | Menor disponibilidade |
| POST duplicado após timeout | Chave idempotente durável com resultado | Índice/transação adicional |
| Listagem de usuário popular | Índice, página limitada, cache medido | Staleness e custo de cache |
| Lag em réplica | Ler do primário para read-your-writes | Pressão maior no primário |
| Consumidor de notificações fora | Outbox e replay duráveis | Entrega eventual e duplicatas |
Não prometa 'exactly once' ponta a ponta só porque o broker confirma uma mensagem. Declare qual efeito é único sob qual chave e quais operações posteriores podem ser reexecutadas.
Etapa 8: valide saturação e recuperação#
Teste autorização entre tenants, escritas concorrentes com a mesma chave idempotente, read-your-writes, limites de corpo e resultados ambíguos após timeout. Meça latências p50/p95/p99, erro e utilização por componente, não somente RPS agregado; então provoque indisponibilidade controlada e observe recuperação [1][2].
Filas não criam capacidade. Num cenário hipotético, uma dependência recebe 1.000 tarefas/s durante 60 s mas processa 700/s; assumindo taxas constantes, sem rejeições nem retries, acumula 18.000 tarefas. Se a entrada depois cair a 400/s e o processamento continuar em 700/s, são mais 60 s para esvaziar. Com entrada igual à saída, a fila não se reduz.
def saldo_fila(entrada, saida, segundos, inicial=0):
    if min(entrada, saida, segundos, inicial) < 0:
        raise ValueError("parametros nao negativos")
    return max(0, inicial + (entrada - saida) * segundos)

pico = saldo_fila(1000, 700, 60)
assert pico == 18000
assert saldo_fila(400, 700, 60, pico) == 0
assert saldo_fila(700, 700, 60, pico) == pico
Esse modelo fluido é uma estimativa de ordem de grandeza, não uma previsão de percentis de espera ou falhas de broker. Antes de acrescentar consumidores, discuta limite de fila, backpressure, rejeição explícita, prioridade, retry e recuperação da dependência. Exponha métricas distintas para entrada, conclusão, backlog, espera e falhas. Um SLO de sucesso não autoriza perder dados confirmados.
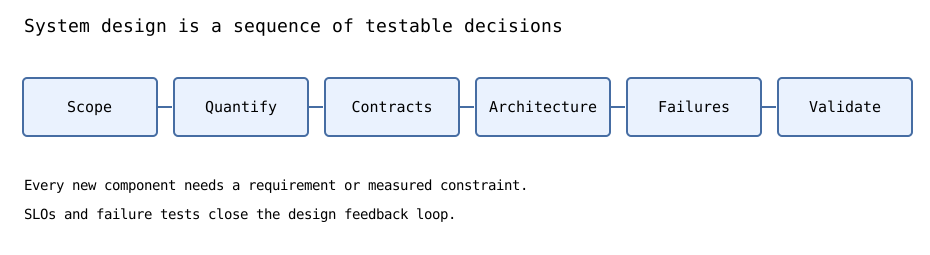
Ordem de explicação para a entrevista: escopo → invariantes → estimativas → APIs/dados → arquitetura mínima → gargalos → falhas → validação. Cada componente adicional exige motivação quantitativa.
Exercícios e verificação#
- Recalcule RPS de pico se o volume diário dobrar e o multiplicador se tornar oito; diferencie hipóteses de medidas.
- Explique por que 99,9% de sucesso de API não permite perda aceitável de notas confirmadas.
- Desenhe uma transação que impeça nota duplicada sob dois retries simultâneos.
- Explique por que réplica pode quebrar read-your-writes e escolha mitigação.
- Identifique a primeira métrica que justificaria cache e o risco de correção introduzido.
Capítulos relacionados: Capacidade, APIs confiáveis, cache e consistência aprofundam as decisões.