Uma trie (árvore de prefixos) indexa strings compartilhando prefixos comuns. Diferentemente da tabela hash, voltada principalmente para encontrar chaves exatas, a trie expõe a organização símbolo por símbolo: cada caminho desde a raiz corresponde a um prefixo. Isso permite autocompletar, contagem por prefixo, dicionários e, com adaptações, correspondência de prefixo mais longo [1].
Modelo de chave e de símbolos#
Defina o que cada aresta representa: byte, ponto de código Unicode, caractere normalizado ou bit. A decisão altera memória e correção. Numa trie por bytes, "é" em UTF-8 ocupa duas arestas; numa trie por pontos de código, uma. A normalização Unicode importa: caracteres visualmente parecidos podem conter sequências diferentes de pontos. Busca sem diferenciar maiúsculas exige regra explícita de case folding. Guardar strings não resolve automaticamente essas questões.
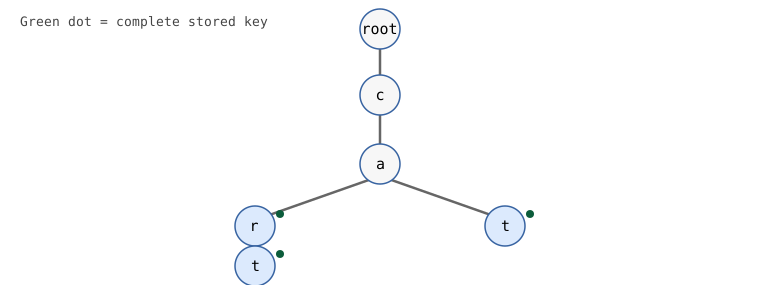
Cada nó possui um mapeamento de símbolo para filho e um indicador terminal de que o caminho até o nó constitui chave completa. A raiz representa prefixo vazio. Nem todo prefixo existente foi cadastrado como palavra. Ao inserir "car" e "cart", o nó de "ca" existe, mas não deve ser terminal; o de "car" é terminal apesar de possuir filho [1].
Invariante estrutural e operações#
Para cada chave armazenada k existe um único caminho desde a raiz que soletra k, e o nó final é terminal. Na inserção, percorra ou crie filhos para cada símbolo e marque o último nó. A consulta exata percorre toda a chave e verifica a marca. A consulta de prefixo precisa apenas alcançar o nó correspondente; isso mostra que algum caminho o contém. A remoção deve desmarcar a palavra e só eliminar nós que não são necessários para outras chaves.
Implementação executável em Python#
class Trie:
    def __init__(self):
        self.raiz = {"final": False, "filhos": {}}

    def inserir(self, palavra):
        no = self.raiz
        for simbolo in palavra:
            no = no["filhos"].setdefault(
                simbolo, {"final": False, "filhos": {}}
            )
        no["final"] = True

    def contem(self, palavra):
        no = self.raiz
        for simbolo in palavra:
            if simbolo not in no["filhos"]:
                return False
            no = no["filhos"][simbolo]
        return no["final"]

    def completar(self, prefixo, limite=None):
        if limite is not None and limite < 0:
            raise ValueError("limite negativo")
        no = self.raiz
        for simbolo in prefixo:
            if simbolo not in no["filhos"]:
                return []
            no = no["filhos"][simbolo]
        saida, pilha = [], [(no, prefixo)]
        while pilha and (limite is None or len(saida) < limite):
            atual, texto = pilha.pop()
            if atual["final"]:
                saida.append(texto)
            for simbolo in sorted(atual["filhos"], reverse=True):
                pilha.append((atual["filhos"][simbolo], texto + simbolo))
        return saida

trie = Trie()
for palavra in ["car", "cart", "cat", "dog"]:
    trie.inserir(palavra)
assert trie.contem("car") and trie.contem("cart")
assert not trie.contem("ca")
assert trie.completar("ca") == ["car", "cart", "cat"]
assert trie.completar("xyz") == []
É uma demonstração com dicionários Python, alocação dinâmica e concatenação de strings, não uma trie compacta otimizada. Aceita intencionalmente string vazia como chave: inserir "" marca a raiz. Prefixo vazio pode enumerar todas as palavras. Uma API de produção deve determinar se essas operações são permitidas e se resultados precisam de ordem lexicográfica ou qualquer ordem.
Complexidade depende do comprimento da chave#
Se L é o número de símbolos de uma chave ou prefixo, inserção e busca exata consomem tempo esperado O(L) assumindo acesso esperado constante ao dicionário de filhos. Enumerar palavras de um prefixo não pode custar sempre O(L): depois de localizar o nó, é necessário percorrer a subárvore e materializar saídas. Se K respostas têm comprimento total Z, há pelo menos Ω(Z) trabalho para formar todas as strings; o custo completo depende também dos nós percorridos.
Se S é a soma dos comprimentos das chaves inseridas, no máximo S+1 nós são criados; compartilhar prefixos diminui o total. Entretanto, um objeto dicionário por nó pode ocupar mais memória que as próprias strings. Um vetor fixo com R ponteiros por nó oferece indexação simples, mas consome O(R) posições por nó, ruim em alfabetos esparsos [2].
Contagem de prefixos, exclusão e compressão#
Guardar contagem de terminais na subárvore permite consultar quantidade de palavras por prefixo após O(L) travessia; inserções e exclusões devem atualizar os contadores. Remover "car" pode apenas desmarcar o nó se "cart" permanece. Após remover "cart", alguns nós podem ser eliminados, mas nunca aqueles usados por "cat". Tries radix ou Patricia comprimem sequências sem ramificação em arestas que armazenam pedaços de strings, diminuindo nós ao custo de divisão e combinação mais complexas.
| Operação | Trie comum | Tabela hash |
|---|---|---|
| Consulta exata | O(L) esperado | Hash O(L) mais hipóteses de consulta |
| Existência de prefixo | O(L) esperado | Sem índice nativo por prefixo |
| Listar palavras de prefixo | Percorre subárvore correspondente | Exige varredura ou índice extra |
| Ordenação | Permite percurso alfabético | Sem ordenação natural |
Tabela hash pode ser menor e mais simples para consultas exatas. Vetor ordenado mais busca binária também permite localizar intervalos com prefixo e pode vencer estruturas com muitos ponteiros num dicionário estático.
Contraexemplos e riscos#
Um erro comum considera qualquer nó alcançado uma palavra: após inserir "cart", a consulta exata "car" retorna verdadeiro indevidamente. Outro erro remove nós compartilhados e faz palavras independentes desaparecerem. Inserções concorrentes não se tornam automaticamente seguras só porque operações isoladas de dicionário parecem atômicas: alterações compartilhadas precisam de sincronização. A política de normalização também deve ser idêntica em gravações e leituras.
Leituras relacionadas: Modelos de colisão em tabelas hash tratam indexação por chave exata; busca binária oferece alternativa com vetor ordenado. Essas estruturas atendem contratos parcialmente diferentes.
Exercícios e verificação#
- Insira "an", "ant" e "and". Demonstre que existe prefixo "a", mas não palavra exata "a". Remover "an" deve preservar as demais.
- Qual o máximo de nós após guardar n strings de comprimento L sem prefixo não vazio compartilhado? Dê limite relacionado a nL.
- Modifique completar para rejeitar prefixo vazio e teste a política antes de iniciar a travessia.
- Implemente contadores por prefixo e atualize-os apenas em inserções de palavras novas, testando repetição.
- Compare a saída com sorted(palavra for palavra in palavras if palavra.startswith(prefixo)) num conjunto reduzido, usando essa implementação independente como oráculo.