SQL descreve quais linhas uma consulta deve produzir; o planejador do banco escolhe como produzir fisicamente esse resultado. Os mesmos dados relacionais podem ser obtidos por caminhos de acesso, ordens de join e quantidades intermediárias muito diferentes. O desempenho SQL não se resume à existência de índice ou tamanho do texto. O diagnóstico separa semântica lógica, custo previsto e tempo observado [1].
Das operações relacionais aos operadores físicos#
Um SELECT pode exigir seleção por filtro, projeção de colunas, join, agrupamento e ordenação. O planejador pode reorganizar operações quando isso preserva semântica, antecipando filtros ou mudando a ordem dos joins. O plano físico escolhe operadores como varredura sequencial, index scan, hash join, merge join, nested loop e sort. A mesma consulta pode receber plano diferente conforme tamanho da tabela, estatísticas e valores dos parâmetros.
O custo do otimizador costuma ser uma estimativa interna relativa, não milissegundos. Comparar custos estimados ajuda a selecionar alternativas, mas concluir que custo 100 no EXPLAIN significa 100 ms é erro conceitual. O planejador trabalha com hipóteses de CPU, disco, distribuição de valores e cardinalidade [1][2].
Seletividade e estimativa de cardinalidade#
Se N é a quantidade de linhas e s a proporção que satisfaz um predicado, o resultado estimado é aproximadamente N×s quando s representa bem a seletividade. Se dois predicados A e B forem independentes, pode-se estimar interseção por s_A×s_B. Correlação rompe a hipótese. Imagine tabela com 10.000 clientes, dos quais 1.000 são brasileiros e todos os 1.000 utilizam determinada configuração regional de pagamento. Cada filtro sozinho seleciona 10%; a independência prevê 10.000×0,1×0,1=100 linhas, mas a conjunção retorna 1.000. Subestimar em dez vezes pode induzir escolha ruim de join ou scan [2].
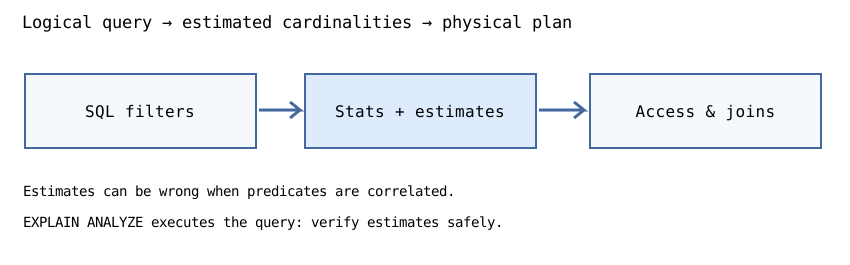
PostgreSQL coleta estatísticas de distribuição, como valores frequentes e histogramas, por ANALYZE; como usa amostras, a estimativa pode falhar para valores raros, distribuição enviesada e colunas correlacionadas [4]. Estatísticas estendidas representam dependências multivariadas que a informação isolada por coluna não captura [2]. Aumentar o alvo estatístico troca tempo e espaço de amostragem por mais informação; não garante plano perfeito.
Ordenação de índices compostos#
Uma B-tree em (tenant_id, created_at) agrupa registros principalmente por tenant e depois por data. Um filtro de igualdade por tenant e intervalo por data restringe região ordenada de forma eficiente. Apenas filtrar created_at geralmente é menos favorável porque a chave inicial fica livre. O PostgreSQL moderno também possui otimização skip scan em certas condições; a afirmação absoluta 'índice nunca serve sem filtrar a primeira coluna' é falsa [3].
Dois índices separados não são necessariamente equivalentes a um índice composto. A chave composta pode preservar ordenação útil; índices individuais podem exigir combinação por bitmap e trabalho extra sobre o heap. Índices aumentam custo de escrita, vacuum e armazenamento. Escolha índices com base em consultas importantes medidas e inspecione o plano real.
Estratégias de join e pressupostos#
O nested loop percorre a entrada interna para cada linha externa, ou pode consultar índice eficazmente com lado externo pequeno e chave interna indexada. O hash join constrói tabela hash numa entrada e consulta com a outra, útil para igualdade quando memória e semântica da chave permitem. O merge join aproveita entradas ordenadas e pode ser bom quando já existem ordenações compatíveis. O planejador precisa estimar resultados intermediários: ordem incorreta de joins grandes pode gerar muito mais linhas que o previsto [1].
| Estratégia | Vantagem | Risco |
|---|---|---|
| Nested loop com índice interno | Entrada externa pequena | Milhares de probes se ela cresce |
| Hash join | Igualdade entre relações grandes | Hash pode extrapolar memória |
| Merge join | Entradas previamente ordenadas | Ordenação custosa se ausente |
| Scan sequencial | Grande parte da tabela | Desperdício sob filtro seletivo |
| Index scan | Poucas linhas procuradas | Leituras aleatórias de heap em massa |
Escolher join por preferência sem estimar linhas não é análise técnica. Forçar index scan apenas porque existe B-tree também pode piorar desempenho: consultar quase todas as páginas pode custar mais que varrer sequencialmente.
EXPLAIN e confronto com a execução real#
EXPLAIN simples mostra plano, custos e linhas previstas sem executar a consulta. EXPLAIN ANALYZE executa de fato a instrução e mostra tempos e contagens observados. Portanto executar INSERT, UPDATE ou DELETE sob EXPLAIN ANALYZE pode alterar dados reais; use rollback explícito ou ambiente de testes. Compare estimado e observado por nó e número de loops, não apenas tempo total. Observe buffers e E/S para separar páginas em cache de acesso ao armazenamento [1].
Um sinal crítico é estimativa de 10 linhas e execução com 100.000 numa etapa inicial: o otimizador pode ter escolhido nested loops supondo resultados pequenos. Planos de baixo tempo de partida, mas enorme custo total, também devem ser avaliados conforme LIMIT e ORDER BY. Os números do EXPLAIN dependem do ambiente; repita com dados, concorrência e cache representativos.
Demonstração executável de cardinalidade#
def estimativa_independente(linhas, *seletividades):
    if linhas < 0 or any(not 0 <= s <= 1 for s in seletividades):
        raise ValueError("linhas ou seletividades invalidas")
    total = linhas
    for s in seletividades:
        total *= s
    return round(total)

assert estimativa_independente(10000, 0.1) == 1000
assert estimativa_independente(10000, 0.1, 0.1) == 100
linhas_correlacionadas = 1000
assert linhas_correlacionadas / estimativa_independente(10000, 0.1, 0.1) == 10
A função modela hipótese de independência, não implementa o otimizador PostgreSQL nem um intervalo estatístico de confiança. A contagem verdadeira decorre da distribuição hipotética descrita, e não de banco real. Para consulta real, obtenha estimativas e medições com EXPLAIN e os dados do ambiente.
Contraexemplos operacionais#
Uma conversão implícita de tipo num predicado pode impedir caminho desejado ou alterar seletividade prevista. Colunas correlacionadas invalidam independência por coluna. ORDER BY sem índice adequado pode gerar ordenação grande. LIMIT pode favorecer planos rápidos no início, mas ruins quando linhas buscadas são raras. Locks e timeouts podem dominar a latência mesmo quando plano e CPU são eficientes.
Evite converter um benchmark em cache aquecido numa garantia geral. Planos mudam depois de ANALYZE, migrações de esquema e alterações grandes de distribuição de dados. O ciclo correto é hipótese → inspeção do plano → medição representativa → ajuste de índice ou consulta → testes de regressão.
Conexão com pré-requisitos: Páginas e WAL explicam tuplas e índices físicos; análise de complexidade distingue modelos de custo de tempo real; cache trata mudanças de latência com dados aquecidos.
Exercícios e verificação#
- Para N=50.000 e predicados independentes com seletividades 0,2 e 0,05, estime 500 linhas. Explique por que correlação pode alterar o resultado.
- Indique quando índice composto (tenant, created_at) ajuda e quando pode ser menos útil que outra estrutura.
- Diferencie EXPLAIN e EXPLAIN ANALYZE, inclusive risco de consultas que modificam dados.
- Descreva situação em que scan sequencial é melhor que índice B-tree existente.
- Com 100 linhas previstas no lado externo de join e 1.000.000 observadas, explique por que nested loop pode ficar caro e quais medições colher.