Uma proposta de System Design precisa resistir a uma revisão arquitetural crítica e construtiva: quem é a autoridade de cada decisão, o que acontece diante de timeout, como o backlog cresce e quais hipóteses mudam sob escala ou restrição regulatória? Desenho com banco, fila e cache não comprova correção. Esta oficina revisa arquitetura hipotética de checkout de marketplace e registra falhas bloqueantes, aprovações condicionadas e trabalhos verificáveis, em vez de declarar genericamente que é “escalável” [1][2].
Proposta inicial: checkout entre serviços#
O candidato propõe API que recebe pedido, consulta disponibilidade em cache Redis, grava pedido, publica OrderCreated no RabbitMQ e cobra cliente num worker separado. Um painel exibe status a partir de índice de busca eventualmente consistente. Há CDN e balanceador global. Os serviços parecem desacoplados e assíncronos; a questão é quais garantias possuem demonstração real.
Requisitos funcionais: conta autorizada envia carrinho, obtém um pedido lógico mesmo após retry, não recebe confirmação de compra para estoque inexistente e consegue consultar resultado do pagamento. Requisitos não funcionais incluem recuperação, isolamento entre tenants, auditoria de referências financeiras e limite para pedido pendente chegar a estado terminal. Nenhuma garantia nasce automaticamente dos retângulos “cache” e “queue”.
Falha bloqueante 1: cache decide estoque vendável#
A proposta autoriza venda usando quantidade armazenada em cache. Dois workers podem ler stock=1 e confirmar compras antes da atualização. Isso quebra invariante: reservas confirmadas não ultrapassam estoque autoritativo. Cache pode exibir estimativa na interface, mas a decisão de reserva precisa de autoridade transacional, como UPDATE condicional executado pelo proprietário dos dados [1].
Separe exibição de commit. Catálogo aceita alguns segundos de atraso; transição de pedido não. Exija teste em que duas requisições independentes disputam a última unidade. Resultado esperado é uma reserva aceita e uma rejeição por indisponibilidade. Mock do cache não prova essa propriedade.
Falha bloqueante 2: evento e commit podem divergir#
Se API confirma pedido no banco e depois publica evento, queda entre as operações deixa pedido sem intenção de processamento. Publicar primeiro e cair antes do commit permite evento de pedido inexistente. É necessário transactional outbox ou protocolo alternativo com fronteira atômica explícita; publisher confirm não equivale a commit que englobe banco da aplicação [2].
Relay pode publicar outbox e cair antes de marcar concluído, gerando duplicata. Consumidor também precisa de idempotência e ID estável. “Usamos RabbitMQ” não explica mensagens duráveis, ACK após confirmar efeito, inspeção de DLQ ou replay que não duplica cobranças.
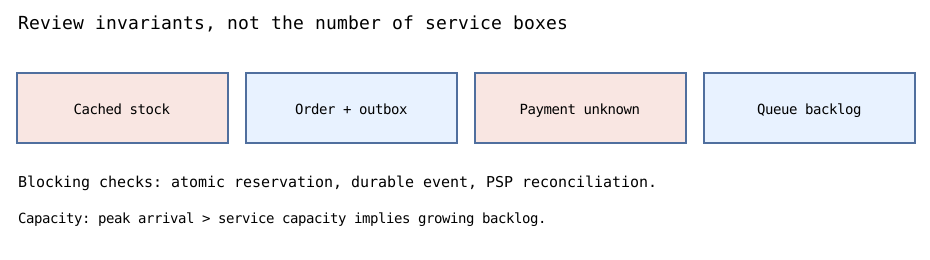
Falha bloqueante 3: timeout de pagamento interpretado como falha#
O PSP pode cobrar e não devolver resposta. Iniciar nova cobrança com outra identidade cria risco de cobrar duas vezes. Um projeto seguro guarda referência durável, usa contrato idempotente do provedor quando disponível e reconcilia estados incertos antes de executar outra ação irreversível. Compensação é operação nova e também pode falhar; não é rollback distribuído mágico [1].
Estados de pedido podem distinguir pending_payment, payment_unknown, paid, cancel_pending e cancelled, conforme processo. Timeout não deve configurar automaticamente payment_failed. A revisão precisa exigir sequência de sucesso, ambiguidade de rede, notificação duplicada e erro no reembolso.
Refazer capacidade quando o pico aumenta#
Considere 150 mil pedidos/dia, duas tarefas assíncronas por pedido e pico 30× a média. Temos 300 mil tarefas/dia / 86.400 ≈ 3,47 tarefas/s em média e aproximadamente 104,17 tarefas/s no pico, sem retries e duplicações. Se workers completam apenas 80 tarefas/s, déficit é cerca de 24,17/s. Uma hora hipotética de pico constante gera backlog de 87 mil tarefas.
from math import ceil
from fractions import Fraction

def taxa_pico(pedidos_por_dia, tarefas_por_pedido, fator_pico):
    if pedidos_por_dia < 0 or tarefas_por_pedido < 0 or fator_pico < 0:
        raise ValueError("carga negativa")
    return Fraction(pedidos_por_dia * tarefas_por_pedido * fator_pico, 86400)

def acumulo_no_pico(chegada, capacidade, segundos):
    if min(chegada, capacidade, segundos) < 0:
        raise ValueError("entrada negativa")
    return ceil(max(0, chegada-capacidade) * segundos)

pico = taxa_pico(150_000, 2, 30)
assert round(float(pico), 2) == 104.17
assert acumulo_no_pico(pico, 80, 3600) == 87000
É cálculo didático de fluxo contínuo. Rajadas, destinos lentos, retries, quotas e distribuição de custos mudam filas e latência. Não demonstra que 80 workers bastam: número de workers difere de capacidade observada em tarefas por segundo. Exija testes de vazão e cauda sobre carga representativa.
Exercício de pane: drenagem da fila#
Suponha indisponibilidade de provedor por 20 minutos enquanto entram 120 tarefas/s constantes. Sem sucesso durante a pane, acumulam-se 144 mil tarefas. Quando serviço volta com 150 tarefas/s de capacidade e entradas continuam a 120/s, sobram só 30/s para limpar backlog, exigindo 4.800 segundos (80 minutos) mesmo sem retries.
def tempo_drenagem(acumulo, chegada, processamento):
    if acumulo < 0 or chegada < 0 or processamento <= chegada:
        raise ValueError("margem positiva necessaria")
    return ceil(acumulo / (processamento - chegada))

assert 120 * 20 * 60 == 144000
assert tempo_drenagem(144000, 120, 150) == 4800
assert tempo_drenagem(0, 120, 150) == 0
A revisão deve rejeitar objetivo de “recuperação em cinco minutos” se cálculos e medidas de capacidade o contradizem. Opções incluem limitar admissão, reservar workers de recuperação, escalonar com justiça por tenant, limitar retentativas e separar prioridades. Custos e justiça mudam, logo são escolhas de produto e engenharia, não apenas tamanho de fila.
Isolamento multitenant e autorização#
Arquitetura atende vendedores e compradores diferentes. ID na URL ou mensagem não autoriza acesso a pedido ou pagamento de outro tenant. Leitura e mutação devem ser vinculadas ao principal autenticado e ao tenant autoritativo, inclusive em processamento assíncrono e exportações. Índice de busca atrasado não pode contornar controle de permissão do banco de pedidos.
Se uma conta emite 80% dos eventos, FIFO global pode dominar workers. Pergunte sobre quotas por tenant, isolamento de grandes clientes, agendamento justo e relação com níveis pagos. Particionamento por tenant pode facilitar roteamento, mas introduz assimetrias e partições quentes.
Aprovação condicional com evidências executáveis#
| Achado | Gravidade | Evidência exigida |
|---|---|---|
| Cache autoriza reserva | Bloqueante | Teste concorrente da última unidade |
| Pedido e outbox sem commit único | Bloqueante | Falhas antes/depois de commit e replay |
| Timeout de pagamento vira rejeição | Bloqueante | Conciliação de resultado desconhecido |
| Backlog sem cálculo | Bloqueante quando há SLO | Teste de capacidade com retries |
| Status baseado somente em índice atrasado | Condicional | Atraso e guarda de autorização |
| Release sem plano de retorno | Risco operacional | Runbook de migração e plantão |
Separe aprovação limitada para primeira versão de alegações sobre prontidão universal. Abrir ticket não corrige achado; é preciso encerrá-lo com testes, runbooks e limites monitorados. A revisão se aplica a um projeto hipotético, não estabelece arquitetura única ideal para todas as organizações.
Exercícios e verificação#
- Demonstre sobrescrita de estoque com duas compras quando cache é usado como autoridade.
- Descreva as duas janelas de crash do dual write banco→broker e broker→banco.
- Proponha estados de pagamento com
unknowndurável e conciliação explícita. - Recalcule backlog de pico se capacidade sobe de 80 para 110 tarefas/s.
- Escreva parecer técnico contendo três achados bloqueantes com testes verificáveis.
Capítulos relacionados: Projeto de pedidos, RabbitMQ integrado, concorrência PostgreSQL e design adaptativo embasam a revisão [1][2].