Duas threads podem executar em núcleos diferentes sem concordar imediatamente com a ordem em que toda alteração de memória fica visível. Compiladores também podem reorganizar ou eliminar operações quando a semântica da linguagem permite. Um modelo de memória determina execuções admitidas, como a sincronização torna dados compartilhados seguros e quais padrões têm comportamento indefinido. Aqui tratamos regras de C++; Python, Java e Assembly possuem modelos relacionados, porém não idênticos [1].
Atomicidade não é ordenação#
Atomicidade significa que uma operação sobre objeto atômico participa do comportamento indivisível especificado para suas modificações; não implica automaticamente ordenar outros endereços. Duas atribuições ordinárias, mesmo sobre palavras alinhadas, não formam transação atômica de dois campos. Declare o invariante: deseja apenas contar incrementos sem perdê-los ou precisa que um consumidor observe um objeto inteiro já inicializado?
Em C++, acessos conflitantes ao mesmo endereço de threads diferentes, quando ao menos um modifica e não há relação happens-before nem proteção atômica adequada, podem constituir data race. A consequência é comportamento indefinido, não simplesmente 'às vezes retorna valor antigo'. As otimizações permitidas ao compilador podem invalidar raciocínios baseados apenas numa intercalação observada da CPU [1].
Sequenced-before, synchronizes-with e happens-before#
Dentro de uma thread, avaliações obedecem às regras sequenced-before da linguagem. Entre threads, certas operações sincronizadas estabelecem arestas synchronizes-with. A combinação transitiva com sequenced-before contribui para a relação happens-before: quando A acontece antes de B nesse sentido, garantias formais de ordem e visibilidade se aplicam [1]. Não é a mesma coisa que instante de relógio ou uma linha temporal universal de cache.
Cada objeto atômico também possui sua ordem de modificação, total para aquele objeto. Objetos atômicos distintos não precisam compartilhar ordem global comum ao usar ordens de memória fracas. Observar flag X atualizada não prova que um payload Y separado esteja publicado com segurança.
Operações relaxed ainda têm utilidade#
Uma operação atômica memory_order_relaxed mantém atomicidade e ordem de modificação de seu objeto, mas não sincroniza por si só acessos comuns a outros objetos [2]. Serve para contagem estatística que exige não perder incrementos, mas não publica necessariamente uma estrutura de dados. Usar flag ready com relaxed como licença para ler payload ordinário sem proteção é incorreto.
Se diversas threads incrementam contador relaxed, a contagem obedece às regras atômicas. Porém ler certo valor não significa ver automaticamente tudo que cada trabalhador alterou em outros endereços. Se a consistência envolve vários campos, use sincronização que cubra o invariante, em vez de pressupor que uma leitura atômica cria transação completa.
Release/acquire para publicação segura#
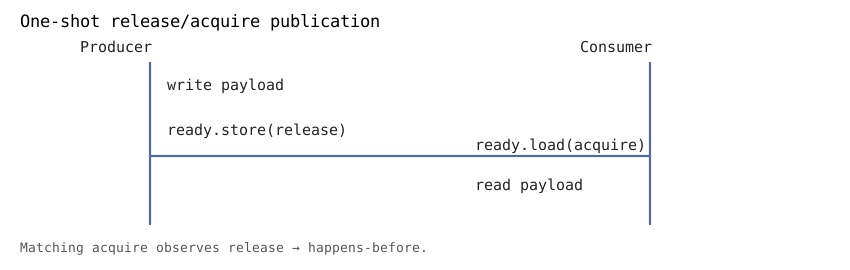
O produtor inicializa objeto e realiza um armazenamento release numa flag atômica. O consumidor lê essa mesma flag com semântica acquire e, após observar o valor liberado pelo produtor (ou valor da sequência de release relevante), acessa os dados inicializados. Acquire bem-sucedido sincroniza com release, estabelecendo visibilidade das escritas anteriores. Acquire numa flag sem relação ou que nunca observa a sequência de release não cria essa conexão [1][2].
#include <atomic>
#include <thread>
#include <cassert>

struct Dados { int esquerda = 0, direita = 0; };
Dados dados;
std::atomic<bool> pronto{false};

void produtor() {
    dados.esquerda = 7;
    dados.direita = 11;
    pronto.store(true, std::memory_order_release);
}
void consumidor() {
    while (!pronto.load(std::memory_order_acquire)) {}
    assert(dados.esquerda == 7 && dados.direita == 11);
}
// Execute produtor e consumidor uma vez e sincronize suas threads.
// Não altere dados concorrentemente após publicar pronto.
O código é um fragmento explicativo, não programa C++ completo. Pressupõe um produtor e ausência de mutações posteriores conflitantes no payload. Uma implementação real precisa de ciclo de vida, reutilização e encerramento; redefinir ready=false sem novo protocolo não resolve publicações repetidas.
Consistência sequencial e limites#
memory_order_seq_cst acrescenta uma única ordem total para as operações atômicas sequencialmente consistentes relevantes, observadas as restrições formais [2]. Facilita o raciocínio em comparação a certas ordens mais fracas, mas não oferece atomicidade automática a um conjunto de campos comuns. Dois contadores seq-cst podem ser individualmente atômicos enquanto o leitor observa valores correspondentes a momentos distintos; um invariante entre ambos exige projeto adicional.
Mutex fornece exclusão ao código que respeita a mesma trava; o protocolo de aquisição/liberação também ordena adequadamente os dados protegidos. Frequentemente isso é mais seguro que desenvolver algoritmo lock-free. Otimize para ordens mais fracas apenas com protocolo demonstrado e medição real, não presumindo que toda instrução relaxed será mais rápida em qualquer CPU.
Experimento: atualização perdida entre passos#
Um programa pequeno enumera etapas de incremento não atômico para ilustrar a importância de leitura-modificação-gravação atômica ou mutex. É um modelo sequencial de intercalações, não simulador completo da memória C++: a versão com data race real possui comportamento indefinido.
from itertools import combinations

def intercalações():
    passos = ("Aread", "Awrite", "Bread", "Bwrite")
    for lugares_a in combinations(range(4), 2):
        lugares_b = [k for k in range(4) if k not in lugares_a]
        sequencia = [None] * 4
        sequencia[lugares_a[0]], sequencia[lugares_a[1]] = passos[:2]
        sequencia[lugares_b[0]], sequencia[lugares_b[1]] = passos[2:]
        yield sequencia

def simular(passos):
    memoria = 0
    registradores = {}
    for passo in passos:
        thread, acao = passo[0], passo[1:]
        if acao == "read":
            registradores[thread] = memoria
        else:
            memoria = registradores[thread] + 1
    return memoria

resultados = {simular(s) for s in intercalações()}
assert resultados == {1, 2}
Cada thread lê e depois grava o incremento em ordem de programa. As seis intercalações incluem situações em que ambas leem zero e gravam um, perdendo atualização. O exemplo isola o risco lógico, mas a especificação C++ não limita uma data race indefinida aos resultados mostrados.
Contraexemplos e fronteiras#
| Padrão | Garantia | O que não garante |
|---|---|---|
| Contador relaxed | Modificações atômicas do contador | Visibilidade de payload não relacionado |
| Release + acquire correspondente | Relação happens-before de publicação | Exclusão de escritores posteriores |
| Operações seq-cst | Ordem total mais forte dessas operações | Transação automática de vários campos |
| Mutex cobrindo invariante | Exclusão e ordem dos participantes | Proteção contra código que ignora mutex |
| Flag volatile comum | Semânticas específicas do compilador | Sincronização geral entre threads em C++ |
Uma variável ordinária volatile não substitui std::atomic para comunicação entre threads. Publicar ponteiro também exige garantir que o objeto apontado continue vivo enquanto houver leitores. Recuperar memória em estruturas lock-free (hazard pointers e épocas, por exemplo) constitui desafio próprio, mesmo quando a atualização atômica do ponteiro está correta.
Exercícios e verificação#
- Por que flag ready com relaxed não basta para publicar campos ordinários?
- Indique qual leitura acquire precisa observar qual escrita release no exemplo.
- Mostre como duas variáveis atômicas podem ainda violar um invariante de saldo conjunto.
- Por que atualização protegida por mutex só funciona quando todos os acessos conflitantes respeitam o mesmo protocolo?
- Execute o modelo Python, encontre sequência que retorna um e explique por que não é prova sobre execuções C++ com comportamento indefinido.
Capítulos relacionados: Concorrência e sincronização apresenta races e locks; processos e memória virtual diferencia mapeamento virtual de ordenação de memória no mesmo espaço de endereçamento.