Um primário PostgreSQL inacessível não está necessariamente parado. Uma partição de rede pode impedir o controlador de se conectar enquanto alguns clientes continuam gravando normalmente nele. Promover standby apenas porque uma verificação expirou cria risco de dois primários graváveis e históricos de transações divergentes. Este capítulo define contrato de promoção que falha de modo seguro, implementa testes determinísticos do seu gate e amplia o laboratório Docker de replicação para recusar promoção com primário antigo ainda em execução. Não implementa fencing independente de produção nem failover automático completo [1][2].
Diferencie suspeita, autoridade e evidência#
Monitoramento produz uma suspeita: o primário A não respondeu no prazo. Isso não prova que A deixou de aceitar gravações. Uma autoridade de fencing separada deve assegurar que A não consegue agir como primário, ou que qualquer operação dele será recusada por autoridade que valida token e época de liderança. Só depois faz sentido promover B.
No laboratório de replicação física, A e B estão em containers PostgreSQL separados com volumes diferentes. O teste agora chama um gate de parada enquanto A ainda roda e exige recusa; em seguida executa `docker stop`, observa novamente estado do container antigo e só então chama `pg_promote` em B.
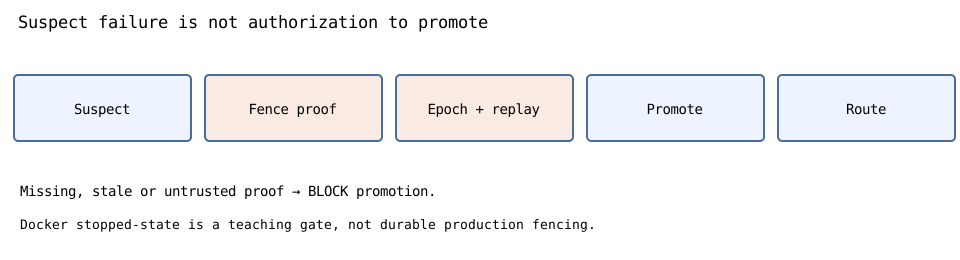
Conferir estado do Docker ajuda nesse ambiente controlado, mas não equivale a fencing duradouro. Outro ator poderia reiniciar A logo depois. Na produção, fencing pode envolver isolamento de energia, desligamento por hypervisor com estado imposto independentemente, lease de storage ou coordenação por sistema de consenso corretamente projetado. Escopo, confiança e comportamento sob falha precisam estar documentados, não presumidos.
Contrato de promoção que falha fechado#
O repositório contém failover_gate.py. O modelo recebe três operações externas: gerar comprovante de fencing, verificar sua autenticidade/aplicabilidade e promover candidato. Incrementa epoch lógico, recusa comprovante de primário errado ou época antiga e nunca chama callback de promoção sem aprovação do verificador.
Uma segunda chamada para promover mesmo candidato não deve executar promoção duas vezes. Essa idempotência é local no modelo, não garantida em controladores independentes reiniciados; um sistema real precisa persistir épocas e liderança por autoridade durável com consenso.
from dataclasses import dataclass

@dataclass(frozen=True)
class ComprovanteFencing:
    antigo_primario: str
    epoca: int
    verificado: bool

def pode_promover(comprovante, esperado, epoca_atual):
    return (isinstance(comprovante, ComprovanteFencing)
            and comprovante.antigo_primario == esperado
            and comprovante.epoca == epoca_atual
            and comprovante.verificado)

assert pode_promover(ComprovanteFencing("A", 8, True), "A", 8)
assert not pode_promover(ComprovanteFencing("A", 7, True), "A", 8)
assert not pode_promover(ComprovanteFencing("B", 8, True), "A", 8)
assert not pode_promover(ComprovanteFencing("A", 8, False), "A", 8)
O campo `verificado` é apenas dado do modelo, não evidência autenticada: atacante ou controlador incorreto poderia marcá-lo verdadeiro. Na fronteira real, a verificação depende de autoridade independente e prova que o candidato não possa forjar. Os testes usam fakes para validar ordem das decisões, não isolamento físico do primário.
Teste negativo obrigatório: recusar primário ativo#
O teste primeiro precisa comprovar que a proteção recusa uma operação inválida. Caso contrário, verificar só “a promoção deu certo depois de parar A” não demonstra que o gate participou. O laboratório Docker usa `docker inspect` enquanto A está ativo e exige que promoção seja recusada. Após parar A, exige observação explícita de estado parado antes de prosseguir.
Os testes unitários recusam ausência de comprovante, recibo destinado a outro primário, época antiga e falha de verificação. Confirmam que somente recibo válido para época corrente alcança callback de promoção. Nenhum teste inventa uma prova física e afirma que desligou alimentação ou isolou storage de um servidor real.
Preparação da réplica é outro gate independente#
Mesmo após isolamento de A, B pode não conter WAL de todos os commits porque streaming PostgreSQL costuma ser assíncrono. O laboratório aguarda um marcador confirmado específico aparecer em B antes da parada; logo, comprova replay dessa transação, não que todos os commits chegaram à réplica. Uma política real pode usar LSNs recebidos, persistidos e reproduzidos, objetivos de durabilidade, condições de confirmação síncrona e perda máxima permitida [1].
Se nenhum candidato atende ao objetivo de ponto de recuperação (RPO), talvez seja necessário manter indisponibilidade em vez de aceitar perda de dados silenciosamente. É decisão operacional e de produto: disponibilidade não é independente das políticas de replicação e consistência.
Por que um lease isolado pode ser insuficiente#
Erro comum é considerar lease expirado do controlador como prova de morte do primário. Controlador pode perder lease enquanto PostgreSQL continua funcionando por pausa longa ou partição de rede. Um desenho real deve assegurar que autoridade antiga cesse gravações quando perder liderança, por exemplo com watchdog que desliga serviço ou fencing externo que continua válido mesmo com falha do controlador [2][3].
Patroni exemplifica a necessidade de armazenamento distribuído de configuração para adquirir lock de líder de modo atômico e renovar liderança. Sua documentação discute relação entre renovação do lock e keepalive de watchdog [2][3]. Isso não significa que escrever “Patroni” num diagrama cria cluster correto: topologia, saúde do DCS, lag da réplica, timeline e procedimentos continuam importantes.
Histórico, roteamento e reintegração do primário antigo#
Depois de promover B, novas escritas criam histórico próprio. A não deve simplesmente reiniciar como outro servidor gravável com timeline anterior. Reintegração controlada pode exigir reconstrução ou rewind a partir da nova autoridade, compatibilidade e registro de divergências. Aplicações precisam descobrir ou ser roteadas para B; pools de conexões antigos não podem continuar gravando em A.
`pg_promote` com sucesso demonstra apenas mudança de estado local no banco. Não prova balanceador atualizado, DNS propagado, todas as aplicações reconectadas ou escritor antigo isolado. Teste completo de aceitação deve observar operações do usuário antes e depois do failover, não somente `SELECT NOT pg_is_in_recovery()`.
Objetivos de recuperação e trade-offs#
Imagine detecção em 15 segundos, confirmação do fencing em 12, promoção em 8 e convergência de roteamento em 10. Modelo serial simplificado produz 45 segundos de recuperação, antes de retries e aquecimento do serviço. Os números são hipotéticos; fases paralelas e latência de cauda mudam resultados reais.
def segundos_recuperacao(deteccao, fencing, promocao, roteamento):
    partes = (deteccao, fencing, promocao, roteamento)
    if any(x < 0 for x in partes):
        raise ValueError("duracoes nao negativas")
    return sum(partes)

assert segundos_recuperacao(15, 12, 8, 10) == 45
Se fencing não pode ser confirmado, estado seguro é bloqueado, potencialmente acima do RTO. Remover proteção só para cumprir disponibilidade pode sacrificar unicidade de escritor. Defina prioridades conforme domínio: pedidos, pagamentos, estoque e outros.
Matriz de falhas e deveres da revisão#
| Falha ou observação | Decisão segura | Evidência necessária |
|---|---|---|
| Primário não responde ao health check | Suspeitar, não promover imediatamente | Estado independente de fencing |
| Comprovante ausente | Bloquear promoção | Teste de recusa |
| Recibo de época antiga | Bloquear | Teste de geração |
| Primário antigo está ativo | Bloquear | Teste negativo Docker |
| Primário parado no teste descartável | Candidato pode ser considerado | Docker e política de replay |
| Primário isolado por rede, mas ainda gravando | Bloquear sem fencing confiável | Integração de partição e fencing |
| Primário antigo volta após promoção | Nunca permitir escrita dupla | Testes de reintegração e roteamento |
Os testes cobrem um contrato de ordem das ações, não sistema HA automático. O experimento seguinte deve incluir coordenador independente e mecanismo de fencing verdadeiro, que não permita dois escritores mesmo quando a comunicação com o controlador falhar.
Exercícios e verificação#
- Explique por que ping sem resposta não prova que o primário deixou de aceitar transações.
- Mostre como comprovante de epoch antiga permitiria promoção insegura se controlador omitisse validação.
- Altere fake para rejeitar comprovante e prove que callback de promoção nunca executa.
- Desenhe teste que grava pelo endpoint antigo depois da promoção de um primário novo.
- Explique como watchdog independente ou controlador de energia impõe fencing quando o processo coordenador trava.
Capítulos relacionados: Replicação e promoção, teoria de failover, write skew e SERIALIZABLE e resposta a incidentes contextualizam o problema [1][2][3].