Arrays e strings fundamentam muitos problemas de programação porque determinam como uma sequência ordenada é representada, indexada, copiada e modificada. Uma solução pode estar logicamente correta e ainda ser ineficiente se desloca elementos repetidamente ou concatena strings imutáveis de grande tamanho. A primeira pergunta deve ser qual representação e quais operações a linguagem realmente oferece? List e str do Python são exemplos úteis, e os princípios se aplicam também a Java, C++ e outras linguagens [1].
Arrays fixos, dinâmicos e listas Python#
Um array fixo convencional armazena n elementos em posições contíguas e de tamanho igual. Com endereço inicial B e largura w, o endereço de i é conceitualmente B+i×w; o cálculo custa O(1). Um array dinâmico acrescenta comprimento lógico n e capacidade C. Quando n=C, o crescimento pode alocar buffer maior e copiar ou mover elementos. A lista Python é um array dinâmico de referências a objetos; os objetos referenciados não precisam estar contíguos nem ter o mesmo tamanho físico [1].
Por exemplo, o array [6,2,9] tem índices 0,1,2. Inserir 4 na posição 1 produz [6,4,2,9], deslocando duas referências. Remover índice 0 desloca as demais. Acessar por índice custa O(1), inserir ou remover perto do começo custa O(n) e percorrer todos os valores custa O(n), onde n é a quantidade de elementos.
Por que append é O(1) amortizado#
Suponha que a capacidade dobre quando o buffer fique cheio. Acrescentar n itens realiza n inserções normais. As cópias de expansões somam menos que 1+2+4+...+2^k, sendo a maior potência inferior a n; a soma geométrica é O(n). Logo n inserções no fim custam O(n) no total, e o custo amortizado de cada uma é O(1), embora uma inserção individual possa custar O(n). Isso não afirma que uma implementação específica necessariamente dobre a capacidade. A demonstração vale para essa política de expansão [3].
Inserir sempre na posição zero é diferente: cada operação desloca os elementos existentes. Inserir n itens na frente pode produzir Θ(n²) movimentos acumulados. Remover da frente de lista Python também desloca referências; quando operações nas duas pontas dominam, prefira deque.
Invariantes de iteração e limites#
Um intervalo semiaberto [lo,hi) inclui lo e exclui hi. Seu comprimento é hi−lo; vazio significa lo=hi. O contrato exige 0≤lo≤hi≤n antes de qualquer indexação. Arrays vazios merecem atenção: consultar índice zero é inválido, mas somar zero elementos produz zero.
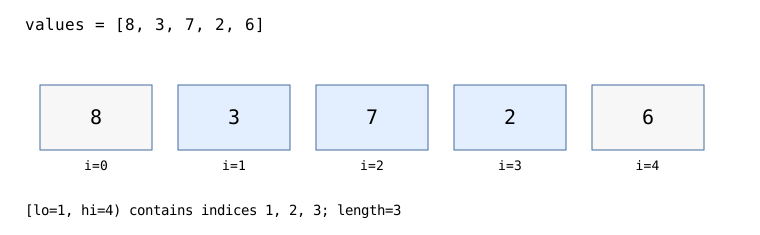
def soma_intervalo(valores, inicio, fim):
    if not 0 <= inicio <= fim <= len(valores):
        raise ValueError("intervalo semiaberto invalido")
    total = 0
    for i in range(inicio, fim):
        total += valores[i]
    return total

assert soma_intervalo([3,-2,7,4], 1, 3) == 5
assert soma_intervalo([], 0, 0) == 0
assert soma_intervalo([8], 0, 1) == 8
try:
    soma_intervalo([8], 0, 2)
    assert False
except ValueError:
    pass
A função custa O(fim−inicio) e espaço auxiliar O(1), sob hipótese de indexação e soma de custo constante. Inteiros arbitrariamente grandes podem exigir aritmética não constante; problemas elementares costumam adotar modelo de palavras de tamanho fixo, salvo ressalva.
Strings são sequências, mas o modelo de caracteres importa#
Strings Python são sequências imutáveis de pontos de código Unicode [2]. Uma string não é necessariamente array de bytes nem sequência de letras percebidas por pessoas. UTF-8 representa pontos de código usando diferentes quantidades de bytes. O símbolo "é" pode ser um ponto de código precomposto ou "e" seguido por acento combinante; essas strings podem parecer iguais e ainda comparar diferentes sem normalização.
Um cluster de grafemas, isto é, o caractere percebido, pode conter vários pontos de código; sequências de emojis também podem agrupar vários. Portanto 'inverter string' é ambíguo sem declarar se trabalha sobre bytes, pontos de código ou grafemas. Índice de ponto de código e índice de caractere visual não são sempre equivalentes.
Custos de cópia, slicing e concatenação#
Como strings Python são imutáveis, operações que criam nova string precisam alocar saída. Um slice de comprimento k costuma custar O(k) de tempo e espaço; concatenar repetidamente strings progressivamente maiores pode copiar o mesmo prefixo muitas vezes. Ao construir saída por partes, acumule fragmentos e use join, observando o comportamento da linguagem utilizada [1].
import unicodedata

def equivalente_canonico(a, b):
    return unicodedata.normalize("NFC", a) == unicodedata.normalize("NFC", b)

assert "é" != "é"
assert equivalente_canonico("é", "é")
assert len("é") == 2

def apenas_letras_ascii(texto):
    partes = []
    for caractere in texto:
        if "A" <= caractere <= "Z":
            partes.append(chr(ord(caractere) + 32))
        elif "a" <= caractere <= "z":
            partes.append(caractere)
    return "".join(partes)

assert apenas_letras_ascii("A-1 b!") == "ab"
assert apenas_letras_ascii("İKÅABCz") == "abcz"
assert apenas_letras_ascii("éΩ") == ""
assert all("a" <= c <= "z" for c in apenas_letras_ascii("İKⒶAZ"))
O contrato é aceitar somente caracteres ASCII de entrada, não normalizar identificadores Unicode. Verifique o ponto de código original antes de converter a caixa: U+0130 (I maiúsculo com ponto) pode produzir vários pontos de código ao passar por lower(), e U+212A (sinal de Kelvin) pode se tornar k, embora nenhum deles seja ASCII. A implementação anterior verificava o texto convertido e aceitava indevidamente essas entradas; a versão corrigida testa diretamente A–Z / a–z e converte apenas maiúsculas ASCII. Identificadores Unicode e símbolos visualmente confundíveis exigem política explícita separada [2]. Não utilize este filtro para senhas, identidade de usuários ou canonicalização criptográfica.
Escolha do algoritmo depende da representação#
| Operação | Array dinâmico/list | String imutável |
|---|---|---|
| Ler índice i | O(1) típico | O(1) no modelo da indexação de pontos de código Python |
| Inserir no final | O(1) amortizado | Cria nova string |
| Inserir na frente | O(n) por deslocamentos | Cria nova string |
| Copiar slice com k elementos | O(k) no Python | O(k) para saída |
| Percorrer tudo | O(n) | O(número de pontos de código) |
Custos exatos dependem da implementação. Não atribua automaticamente as mesmas garantias de memória a Python e a um buffer char fixo de C++. Calcular o hash de uma string normalmente inspeciona seu conteúdo na primeira vez, mesmo que caching mude o custo de chamadas repetidas. Dados ordenados admitem two pointers e busca binária, mas é necessário comprovar a pré-condição.
Quando usar outra estrutura#
Arrays são ruins para inclusões arbitrárias frequentes na frente, enquanto listas ligadas trocam acesso por índice por mudanças de ponteiros. Muitos slices pequenos copiados podem consumir banda de memória, ainda que o algoritmo pareça ter poucos loops. Strings imutáveis facilitam o raciocínio, mas concatenação ingênua pode ser quadrática. Algoritmos sobre bytes aplicados a texto Unicode podem cortar um símbolo codificado e gerar dados inválidos.
Exercícios e verificação#
- Para [7,4,9,2], calcule deslocamentos ao inserir na posição 1 e ao remover índice 0.
- Deduza a soma geométrica das cópias sob duplicação de capacidade e explique por que um append isolado ainda pode custar O(n).
- Demonstre o invariante 0≤lo≤hi≤n num percurso de intervalo semiaberto.
- Explique por que "é" e "e" seguido por acento podem ter comprimentos diferentes em Python.
- Reescreva soma_intervalo usando sum sobre um slice; confira o resultado e explique como o slice altera memória auxiliar.
Próximas leituras: Listas ligadas e pilhas e filas comparam representações; busca binária exige acesso indexado ordenado.