Incidente de produção é interrupção ou risco a um contrato de serviço que demanda ação coordenada. O objetivo inicial é reduzir o dano aos usuários e estabilizar o sistema, não demonstrar imediatamente uma teoria elegante de causa raiz. A investigação aprofundada continua depois da recuperação. Uma resposta confiável depende de autoridade definida, evidências compartilhadas, registro de decisões e comunicação, especialmente quando há vários serviços e equipes [1].
Declare gravidade pelo impacto observável#
Defina níveis de severidade previamente segundo funções críticas, usuários atingidos, duração, integridade de dados e exposição de segurança. Pico 5xx em endpoint de teste com pouco tráfego merece tratamento diferente de pagamentos perdidos ou vazamento entre tenants. Use falhas medidas, latência e população atingida; se faltam dados, registre a incerteza em vez de inventar percentuais exatos.
Um SLI mede população operacional numa janela definida. Se 1.200 de 60.000 chamadas elegíveis falham em 20 minutos, a taxa observada de falha é 2%. Isso não significa necessariamente 2% dos usuários: uma pessoa pode realizar várias chamadas. Separe requisições, usuários únicos, transações e efeitos de negócio persistidos quando as grandezas são diferentes.
Comando de incidentes e responsabilidades#
O modelo de gestão de incidentes do Google enfatiza coordenação, comunicação e controle, com papéis como comandante, líder operacional e responsável pela comunicação [1]. O comandante estabelece prioridades e autoridade de ação. A operação executa rollback, redirecionamento ou mitigação. Comunicação fornece atualizações úteis aos interessados. Num incidente pequeno esses papéis podem ser combinados conscientemente; num grande, separá-los evita que as perguntas interrompam a investigação sem limites.
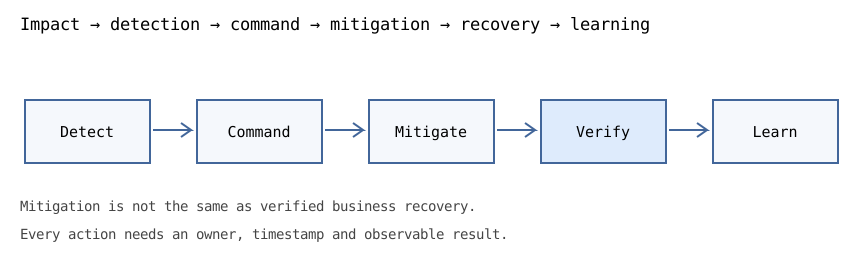
Estabeleça um canal autoritativo, linha do tempo com horários e fontes, e responsável por cada alteração. Pause deployments de risco sem relação com a recuperação e evite pessoas alterando o mesmo recurso sem coordenação. Mitigação que melhora uma região, mas piora outra, é experimento limitado, não recuperação global.
Mitigue primeiro, investigue com segurança#
Comece com medidas reversíveis e compatíveis com a evidência: reverter release suspeita, desativar recurso por flag, rejeitar excesso de tráfego ou executar failover somente quando dados e autoridade permitirem. Rollback pode ser inseguro após migração incompatível de esquema ou gravação em novo formato. Havendo suspeita de ataque, exigências de preservação de evidências e contenção podem limitar procedimentos comuns de depuração [3].
Escolha ações considerando redução esperada do dano, reversibilidade, risco e possibilidade de medir o resultado. Se dependência está saturada, aumentar retries a montante pode agravar a pane. Se banco sofre contenção de locks, duplicar réplicas da aplicação pode intensificá-la. A resposta deve derivar do modelo de falhas, não de uma lista de receitas sem diagnóstico.
Quantifique os marcos temporais e o impacto#
Registre pelo menos início do impacto ao cliente, detecção, reconhecimento, mitigação e recuperação verificada. A detecção nem sempre coincide com início: monitoramento pode descobrir tarde. Reconhecer não é mitigar, e mitigar não é concluir recuperação. Para calcular médias de detecção ou recuperação, defina população e marcos antes: duração de incidente único não é média.
from datetime import datetime

def duracoes_incidente(impacto, detectado, mitigado, recuperado):
    instantes = [datetime.fromisoformat(valor.replace("Z", "+00:00"))
                 for valor in (impacto, detectado, mitigado, recuperado)]
    if any(t.tzinfo is None for t in instantes) or instantes != sorted(instantes):
        raise ValueError("horarios devem ser ordenados e ter fuso")
    inicio, deteccao, mitigacao, recuperacao = instantes
    minutos = lambda a,b: (b-a).total_seconds() / 60
    return {
        "deteccao_minutos": minutos(inicio, deteccao),
        "mitigacao_minutos": minutos(inicio, mitigacao),
        "recuperacao_minutos": minutos(inicio, recuperacao),
    }

medidas = duracoes_incidente(
    "2026-01-01T10:00:00Z", "2026-01-01T10:07:00Z",
    "2026-01-01T10:22:00Z", "2026-01-01T10:36:00Z"
)
assert medidas == {
    "deteccao_minutos": 7.0,
    "mitigacao_minutos": 22.0,
    "recuperacao_minutos": 36.0,
}
Os horários são hipotéticos. A função calcula intervalos sob a definição escolhida, mas não descobre quando o primeiro usuário foi afetado nem se os dados estão seguros. Se sistemas usam relógios diferentes, concilie-os ou anote a incerteza. Respostas HTTP normais podem esconder fila assíncrona ainda com trabalho perdido.
Comunicação durante o incidente#
Uma atualização útil informa o que está afetado, início caso conhecido, estágio da mitigação, o que o usuário deve fazer e periodicidade das próximas atualizações. Não apresente causas especulativas nem declaração definitiva de recuperação sem verificação. Logs internos podem identificar pessoas ou clientes; comunicações externas precisam proteger confidencialidade e obedecer obrigações de segurança. Um responsável pela comunicação permite continuidade técnica sem silêncio ou mensagens contraditórias [1].
Página de status não é fonte de verdade sobre perda de dados. Se efeitos financeiros ou de segurança são incertos, comunique a incerteza e explique como a reconciliação vai esclarecê-la. Incidentes regulados podem implicar prazos legais e preservação de evidências próprios, além de mensagens comuns de disponibilidade [3].
Verificação antes de encerrar#
Reabra tráfego gradualmente se a mitigação alterou distribuição de carga. Verifique erros, p95/p99, saturação, efeitos duráveis, pendências em filas, lag de réplicas e caminhos dos usuários afetados. Frontend recuperado não prova consistência de um backend previamente danificado. Se transações foram aceitas durante a falha, reconcilie com o armazenamento autoritativo. Registre problemas restantes e responsáveis; 'parece normal' não constitui critério formal.
| Pergunta | Evidência de encerramento |
|---|---|
| Chamadas estão funcionando? | SLI no volume de tráfego acordado |
| Todo trabalho terminou? | Fila e reconciliação |
| Dados estão corretos? | Invariantes de negócio e comparação autoritativa |
| A pane pode voltar imediatamente? | Gatilho desativado ou sob controle |
| Usuários foram informados? | Atualização final baseada na evidência |
Postmortem sem culpabilização e com ações concretas#
Um postmortem registra impacto, linha temporal, lacunas de detecção, fatores contribuintes, decisões de mitigação e ações posteriores [2]. Sem culpabilização significa entender por que decisões pareciam adequadas com as informações e ferramentas existentes; não significa esconder escolhas equivocadas ou eliminar responsabilidades. Evite a ficção de uma causa única quando vários fatores interagiram. Diferencie gatilho (por exemplo um deploy) de fraquezas sistêmicas (proteções ausentes, retries perigosos ou falta de testes de capacidade).
Cada ação corretiva precisa de responsável, condição de aceitação mensurável e prazo ou prioridade. 'Melhorar monitoramento' é vago. 'Alertar em cinco minutos quando a taxa 5xx ultrapassar um burn rate especificado em duas janelas, comprovado por teste sintético de falha' é verificável. Não basta marcar item como feito sem evidência de regressão corrigida.
Incidentes SRE e incidentes de segurança#
Problemas de confiabilidade e cibersegurança se sobrepõem, mas não são idênticos. A NIST SP 800-61 Revisão 3 integra resposta a incidentes de segurança ao gerenciamento contínuo de riscos: ataques podem exigir contenção, integridade de evidências, coordenação com áreas legais e recuperação diante de um adversário ativo [3]. A estrutura operacional de comando ajuda, mas o playbook de indisponibilidade não basta para credenciais comprometidas ou exploração ativa.
Exercícios e verificação#
- Com 1.200 falhas em 60.000 chamadas elegíveis, calcule 2% e explique por que a fração de usuários afetados pode diferir.
- Se impacto começa às 10h, detecção às 10h07 e recuperação às 10h36, separe tempo de detecção da duração total.
- Escreva atualização de status em três frases, comunicando escopo e ações sem afirmar causa ainda incerta.
- Proponha rollback e um exemplo de migração de banco que torne essa reversão insegura.
- Transforme 'prevenir novas panes' numa ação mensurável com responsável e teste de aceitação.
Capítulos relacionados: Observabilidade define evidências e SLOs, APIs confiáveis analisa retries e sobrecarga, e replicação e failover aborda perda de dados na recuperação.