Um banco com primário gravável e uma ou mais réplicas em espera pode replicar mudanças confirmadas para disponibilidade e escalabilidade de leitura. Replicação não equivale a backup, não garante consenso global automaticamente nem transforma todo failover em operação sem perda. Avalie quando uma escrita é confirmada ao cliente, onde o log está durável, até onde cada réplica aplicou alterações e qual nó tem autoridade para novas escritas. O envio físico de WAL do PostgreSQL oferece um caso concreto [1].
Distinga geração, transporte, flush e replay#
O primário gera registros do write-ahead log (WAL) ao modificar o banco. A réplica recebe WAL e reproduz alterações para reconstruir páginas. São eventos diferentes: o registro pode ser gerado, transmitido, recebido, gravado de modo durável na réplica e aplicado para leitura em instantes distintos [1][2]. A posição lógica no log, chamada LSN, permite comparar avanço. Posição recebida elevada não prova, sozinha, que as consultas já observam aquela transação.
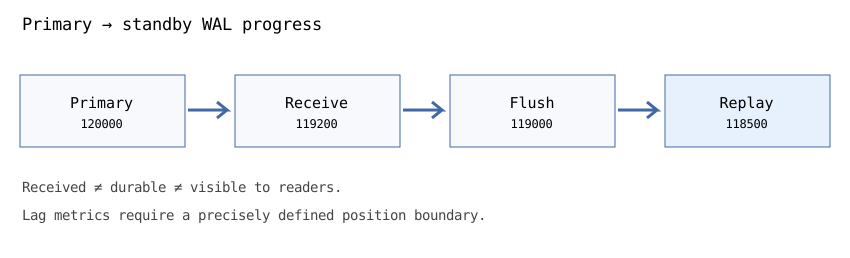
Para cada transação, determine a fronteira de durabilidade desejada. Se basta sobreviver à queda local de processo, o contrato difere de exigir cópia remota duravelmente confirmada. A decisão afeta latência e modos de falha.
Replicação assíncrona e o que não se pode prometer#
No PostgreSQL, o streaming comum é assíncrono por padrão. O primário pode confirmar transação localmente antes que o WAL chegue à réplica. Se o primário falha definitivamente e uma réplica atrasada é promovida, o novo primário pode não conter transações já consideradas concluídas pelos clientes [1]. Isso representa risco de perda segundo o RPO, não somente leitura lenta. A perda depende das posições persistidas, da sobrevivência do armazenamento e do procedimento de troca.
Atraso de réplica pode resultar de rede, disco lento, conflitos de replay e rajadas. Um único indicador em segundos pode enganar durante períodos ociosos; verifique se mede transporte, flush durável, aplicação ou aproximação de relógio. Diferença entre posições do log em bytes é distinta do tempo de aplicação, e convertê-la para segundos exige taxa de geração medida.
Replicação síncrona e significado do ACK#
A replicação síncrona do PostgreSQL pode aguardar respostas de réplicas selecionadas conforme configuração e modo de commit; receber, gravar remotamente e aplicar/mostrar para leitura são garantias distintas [1]. Uma gravação que aguarda flush durável de uma réplica resiste melhor à perda definitiva do primário do que uma gravação confirmada somente localmente, desde que o armazenamento remoto sobreviva e essa réplica seja escolhida adequadamente no failover. Flush remoto não prova que todas as réplicas aplicaram mudanças nem que qualquer leitura arbitrária já está atualizada.
Aguardar réplicas aumenta latência e pode diminuir disponibilidade das escritas quando nenhuma réplica exigida responde. No modo assíncrono, o primário pode manter disponibilidade, mas com janela potencial de perda de alterações confirmadas. Nenhuma dessas opções dispensa recuperação de desastre. Em sincronização entre regiões, latência física da rede pode dominar o orçamento de commit.
Consistência de leitura e sessão#
O cliente grava no primário e consulta imediatamente uma réplica que ainda não reproduziu WAL correspondente. Ela pode devolver dado antigo mesmo após confirmação da escrita. Para oferecer read-your-writes, direcione temporariamente a sessão ao primário ou aguarde até a réplica aplicar pelo menos o LSN daquela escrita, com prazo máximo e fallback. É contrato de roteamento e replicação, não do formato JSON.
Uma réplica pode atender leituras que toleram dados obsoletos, mas geralmente não aceita escritas, e consultas podem conflitar com recuperação. O cache pode introduzir atraso adicional ao da réplica. Defina operações que toleram staleness e aquelas que exigem leitura autoritativa ou posição sincronizada.
Modelo pequeno e testável de posições#
O programa modela deslocamentos inteiros em bytes, não a sintaxe real de LSN nem o protocolo PostgreSQL. Distingue três posições monotônicas e rejeita ordem impossível.
def posicoes_replica(primario, recebido, gravado, aplicado):
    if not 0 <= aplicado <= gravado <= recebido <= primario:
        raise ValueError("ordem de WAL invalida")
    return {
        "lacuna_recepcao_bytes": primario - recebido,
        "lacuna_durabilidade_bytes": primario - gravado,
        "lacuna_visibilidade_bytes": primario - aplicado
    }

exemplo = posicoes_replica(120000, 119200, 119000, 118500)
assert exemplo["lacuna_recepcao_bytes"] == 800
assert exemplo["lacuna_durabilidade_bytes"] == 1000
assert exemplo["lacuna_visibilidade_bytes"] == 1500
assert posicoes_replica(8,8,8,8)["lacuna_visibilidade_bytes"] == 0
try:
    posicoes_replica(100,90,80,95)
    assert False
except ValueError:
    pass
Essas desigualdades descrevem um instantâneo simplificado do mesmo fluxo e posições comparáveis. Servidores reais podem apresentar timelines distintas, mudanças de configuração, checkpoints e medições colhidas em momentos diferentes. Não use medições não sincronizadas como prova de ordem. Lag zero não garante que a réplica continue atualizada após novas gravações.
Slots de replicação e risco de encher o disco#
Slots de replicação mantêm informações necessárias aos consumidores; no streaming físico podem impedir remoção prematura do WAL exigido por uma réplica [1][3]. Isso preserva continuidade, mas cria passivo de armazenamento: slot abandonado ou parado pode reter WAL indefinidamente até saturar disco. Monitore retenção por slot e estabeleça limites operacionais adequados. Resolver slot obsoleto pode exigir ressincronizar uma réplica, não apagar segmentos arbitrariamente.
Backup e arquivo de WAL têm finalidades distintas de réplica em execução. Replicação também pode propagar exclusões acidentais ou corrupção lógica a todos os seguidores. Backups isolados/imutáveis e exercícios de restauração são necessários. RTO (tempo máximo aceitável de recuperação) e RPO (perda máxima admitida) devem ser definidos separadamente: failover rápido não assegura perda baixa.
Promoção, fencing e split brain#
Quando o primário fica inacessível, inacessível não significa desligado. Promover réplica enquanto o primário antigo ainda aceita gravações provoca split brain e histórias divergentes. Um failover seguro exige impedir que o primário antigo permaneça gravável, por fencing efetivo ou protocolo correto de autoridade/lease, e redirecionar clientes de modo controlado. Alterar DNS sem cercar o primário antigo não basta.
A promoção também exige escolher réplica com posição persistida apropriada, verificar compatibilidade de timelines e reconectar ou reconstruir seguidores. Uma mudança automática exige provas de saúde, quórum e autoridade; script que promove apenas porque ocorreu timeout curto pode trocar correção por aparência de rapidez.
Decisão de recuperação calculada#
Suponha primário na posição WAL 120.000, réplica aplicada em 118.500 e flush até 119.000 quando o armazenamento primário se perde definitivamente. Existe lacuna de durabilidade de 1.000 bytes em relação à observação; os 500 bytes recebidos mas não confirmados por flush só seriam recuperáveis se tivessem sobrevivido, o que não se deve presumir. O impacto lógico depende das fronteiras dos registros e das transações anteriormente confirmadas, não apenas de bytes. Um relatório distingue perda potencial estimada de transações comprovadamente perdidas.
| Situação | Risco | Proteção explícita |
|---|---|---|
| Primário assíncrono perdido | Escritas confirmadas ausentes | RPO, WAL e backups |
| Leitura após escrita | Estado desatualizado | Espera por LSN ou leitura no primário |
| Réplica síncrona indisponível | Commit pode aguardar | Decisão documentada de degradação |
| Slot abandonado | WAL satura armazenamento | Monitoramento da retenção |
| Primário antigo gravável | Timelines divergentes | Fencing antes da promoção |
Exercícios e verificação#
- Por que WAL recebido ainda pode ser invisível às consultas?
- Monte cronologia em replicação assíncrona na qual transação confirmada desaparece após failover.
- Para primário 10.000, flush 9.900 e replay 9.700, calcule lacunas e diga qual afeta diretamente visibilidade.
- Projete leitura após escrita por sessão e descreva fallback quando réplica não alcança posição exigida.
- Justifique por que a automação deve impedir escritas no primário antigo antes de direcioná-las à réplica promovida.
Leituras relacionadas: WAL e páginas, modelos de consistência e consenso Raft tratam camadas diferentes de durabilidade e autoridade.