Um exercício de System Design não se resolve desenhando fila e banco. Uma boa resposta começa com semântica do negócio, carga, autoridades e definição de falha, e muda o projeto quando o entrevistador altera requisitos. Esta oficina original projeta um serviço multitenant de webhooks de saída: clientes SaaS cadastram endpoints, o produto emite eventos e workers enviam chamadas HTTP assinadas. É exercício didático, não questão oficial ou recuperada de entrevista. Orientações públicas de projeto valorizam esclarecer requisitos e avaliar praticidade, confiabilidade e escala, não memorizar diagramas [1].
Enunciado, requisitos e perguntas de esclarecimento#
O problema inicial é: “Projete serviço de webhooks que envie cada evento confirmado de uma conta às URLs inscritas”. Antes do diagrama, pergunte o que significa entregue. Neste estudo, significa que o endpoint remoto retornou 2xx válido antes do deadline do cliente. Não significa que o destinatário concluiu processamento ou persistiu efeito próprio. Suponha tentativas pelo menos uma vez, retenção/retry máximo de 24 horas, autorização por tenant, consulta de status e rotação de segredo de clientes.
Esclareça inscrições por evento, payload máximo, atraso aceitável, exigência de ordem, políticas de retry e possibilidade de replay. Aqui não garantimos ordem entre IDs de evento diferentes. Ordenação por objeto pode ser acrescentada por particionamento e consumidores seriais, mas reduz vazão e cria bloqueio na cabeça da fila. Defina também o que acontece se inscrição é desativada após entrar na fila: o worker deve verificar política atual antes de enviar.
Modelo de capacidade com hipóteses explícitas#
Considere 200 mil eventos de origem/dia, três inscrições ativas em média por evento e pico de 50× a média de tarefas. São 600 mil tarefas/dia ÷ 86.400 segundos ≈ 6,94 tarefas/s, com pico hipotético de aproximadamente 347,2 tarefas/s antes das retentativas. Se um worker suporta 60 tentativas HTTP/s medidos para a distribuição de timeouts planejada, seis workers cobrem pico sob divisão ideal, e o sétimo pode fornecer reserva N+1. Quotas dos destinos, assimetria entre tenants e retries invalidam facilmente essa aritmética.
Bytes e tentativas são medidas distintas. Corpo de 2 KiB a 350 tentativas/s representa cerca de 700 KiB/s de payload, sem overhead HTTP/TLS. Um evento com três inscrições produz três identidades de entrega, não necessariamente três sucessos. Capacidade de armazenamento inclui outbox, histórico de tentativas, índices e retenção; multiplicar apenas por tamanho do corpo não explica tudo.
Autoridade, dados e contrato de aceite#
O produtor do evento é autoridade para dizer se um evento foi confirmado. Ele grava mudança de negócio e outbox na mesma transação local. O relay de webhooks publica ID estável e contexto de roteamento no broker. Dispatcher resolve inscrições relevantes e cria entregas únicas por (event_id, subscription_id). Um cadastro de inscrições controla endpoint, tenant, status ativo, versão de segredo e política de taxas.
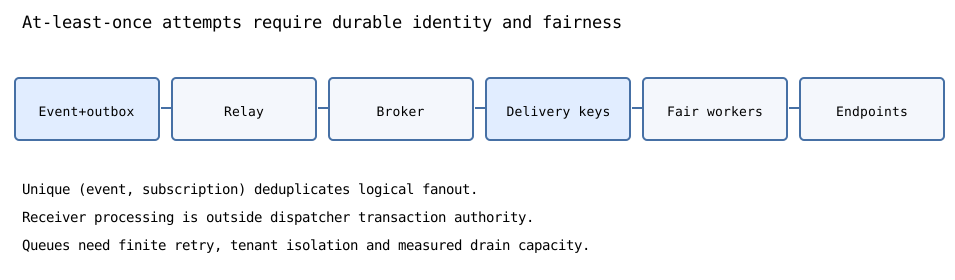
Modelo possível: Event(id, tenant_id, type, created_at), Subscription(id, tenant_id, url, active, secret_version), Delivery(event_id, subscription_id, state, next_attempt_at, attempts, lease_version) e Attempt(delivery_id, attempt_no, response_class, duration). Constraint única em Delivery torna fanout logicamente idempotente; leases com compare-and-swap impedem dois workers saudáveis de reivindicar mesma linha. As garantias pertencem ao armazenamento durável, não ao dicionário local do Python.
Uma API interna pode expor GET /v1/webhook-deliveries/{id} somente ao tenant autenticado e replay com IDs estáveis. Não permita consultar subscriptions alheias por IDs adivinháveis: isso pode revelar URLs e conteúdo. O consumidor autentica o emissor verificando assinatura de payload, timestamp e proteção contra replay, conforme contrato dos clientes.
Por que filas não geram exactly once#
O relay pode publicar e cair antes de marcar outbox como concluído, enviando evento duplicado ao broker. Um worker pode executar webhook que o cliente processa, mas perder a resposta. Retry pode acionar novamente efeito de negócio remoto. Assinatura HTTP comprova autenticidade sob boas condições de segredo, mas não torna processamento exatamente uma vez. Envie identidade estável de evento/entrega para o destinatário persistir chave de deduplicação atomicamente com o próprio efeito, se possível [2].
Para justiça entre tenants, não permita que uma única inscrição ruidosa ocupe ilimitadamente FIFO global e atrase todos. Use filas limitadas, limites por tenant e agendamento justo, com métricas por conta. Diferencie tratamento de 4xx persistentes ou endpoints inválidos (quarentena) de timeouts e 5xx potencialmente transitórios, respeitando política documentada.
Retentativas com crescimento exponencial limitado#
Um exercício simples usa backoff exponencial com teto. Para tentativa n iniciando em um, atraso = min(teto, base × 2^(n−1)). Na produção é necessário adicionar jitter, orçamento total de deadline, limites por tenant e regras por resposta; retries determinísticos em massa podem sincronizar picos [3].
def atraso_tentativa(tentativa, base=2, teto=300):
    if not isinstance(tentativa, int) or tentativa < 1:
        raise ValueError("tentativas iniciam em um")
    if not isinstance(base, int) or not isinstance(teto, int) or base <= 0 or teto <= 0:
        raise ValueError("tempos inteiros positivos necessarios")
    expoente = min(tentativa - 1, teto.bit_length() + 2)
    return min(teto, base * (2 ** expoente))

assert [atraso_tentativa(n) for n in range(1,7)] == [2,4,8,16,32,64]
assert atraso_tentativa(30) == 300
try:
    atraso_tentativa(0)
    assert False
except ValueError:
    pass
A função assume segundos inteiros e ilustra política local, não agenda real. Tentativa não inteira ou negativa é inválida. Limitar expoente evita alocar números gigantes. Workers reais precisam persistir next_attempt_at, verificar inscrição ativa e nunca superar prazo de retenção.
Backlog e aritmética de recuperação#
Imagine falha de rota de rede por 15 minutos enquanto chegam aproximadamente 350 tarefas/s constantes. A fila acumula 350 × 900 = 315 mil tarefas, ignorando retries e timeouts já consumidos. Depois da recuperação, se despacho saudável é 500 tarefas/s e novas entradas continuam 350/s, a margem de drenagem é somente 150 tarefas/s. Limpar o acúmulo requer 315.000 ÷ 150 = 2.100 segundos, ou 35 minutos, mesmo após a rede voltar [3].
from math import ceil

def segundos_drenagem(entrada, segundos_pane, processamento):
    if entrada < 0 or segundos_pane < 0 or processamento <= entrada:
        raise ValueError("sem margem positiva")
    pendencias = entrada * segundos_pane
    return pendencias, ceil(pendencias / (processamento - entrada))

assert segundos_drenagem(350, 900, 500) == (315000, 2100)
assert segundos_drenagem(0, 600, 500) == (0, 0)
try:
    segundos_drenagem(350, 900, 340)
    assert False
except ValueError:
    pass
São aproximações de fluxo contínuo, não garantias sobre latência de cauda. Se retries consomem 200 tentativas adicionais/s na recuperação, capacidade para novos trabalhos e drenagem pode desaparecer. A análise correta inclui orçamento de retries, quotas, prioridades, idade de filas e domínios de falha por URL.
Mude o requisito durante a apresentação#
Boa arquitetura responde a mudanças em vez de proteger o desenho original. Suponha que um tenant empresarial gere 70% dos eventos. FIFO global cria bloqueio para os outros: use agendamento por tenant ou weighted fairness, monitore quotas e reconheça complexidade adicional. Suponha que clientes exijam ordem por objeto. Particione por (tenant_id, object_id) e use consumidor lógico serial ou ledger sequenciado, reconhecendo que uma mensagem falha pode impedir as seguintes salvo política de salto.
Agora suponha exigência regulatória de excluir payloads após 24 horas, mantendo métricas agregadas. Separe retenção do payload e de tentativas, remova dados de logs e documente se replay existe após vencimento. Se o endpoint ficar dois dias indisponível, política de 24 horas significa que o serviço não pode prometer entrega posterior. Exponha estado terminal e semântica clara de repetição.
Rubrica, experimentos e falhas#
| Decisão | Evidência necessária | Alegação sem suporte |
|---|---|---|
| Aceite durável | Mudança de negócio e outbox no mesmo commit | Ack de broker equivale ao commit |
| Identidade | Par único evento/inscrição | Broker garante efeito exatamente uma vez |
| Backoff | Retry limitado com jitter/deadline | Mais retries sempre são melhores |
| Isolamento | Escalonamento justo e quotas medidas | Uma FIFO é justa para todos |
| Ordem | Contrato explícito de partição e sequência | Timestamps dão ordem global |
| Recuperação | Margem de drenagem, replay e reconciliação | Fila esvazia imediatamente ao voltar |
Verifique publicação duplicada do relay, workers concorrentes, resposta 2xx perdida após efeito no cliente, acesso cruzado entre tenants, rotação de segredo, endpoints desativados e recuperação sob tráfego desigual. Acompanhe atraso commit→2xx em p50/p95/p99, tentativas, idade máxima da fila, justiça por tenant, entregas descartadas/vencidas e assinaturas inválidas.
Exercícios e verificação#
- Deduza pico de 347,2 tarefas/s e explique por que tempestade de retries pode excedê-lo.
- Mostre duas etapas de falha que provam que mesmo outbox perfeito não assegura exactly once no destinatário.
- Modifique a regra de retry com jitter gerado por seed determinística apenas para teste e declare limitações.
- Recalcule drenagem quando processamento efetivo cai de 500 para 400 tarefas/s e entradas permanecem 350/s.
- Desenhe teste de autorização que impede tenant A de consultar ou repetir entrega de tenant B.
Capítulos relacionados: Método de System Design, idempotência, filas, notificações e fronteiras de serviços explicam fundamentos.