Promoção bem-sucedida de standby não informa quanto tempo clientes ficaram sem atendimento nem quantos commits podem estar ausentes. Recovery Time Objective (RTO) define duração aceitável de interrupção; Recovery Point Objective (RPO) define idade ou volume aceitável de dados perdidos em relação ao ponto de recuperação. São objetivos de negócio, não números inferíveis por uma única consulta de estado do banco. Este laboratório instrumenta fases reais de replicação física e promoção manual PostgreSQL 17, registra durações com relógio monotônico e injeta isolamento de rede no primário para demonstrar que conectividade e autoridade de escrita são conceitos distintos [1][2].
Declare o alcance da medição antes de divulgar RTO#
O experimento de replicação cria primário e standby PostgreSQL em containers Docker separados, executa base backup físico, reproduz WAL e aguarda uma linha de teste confirmada ficar visível na réplica. A instrumentação registra quatro instantes no mesmo runner de CI: imediatamente antes da solicitação de parada controlada do primário, depois de Docker confirmar sua parada, depois de `pg_promote` concluir e depois do primeiro novo INSERT confirmar na réplica promovida.
O intervalo entre primeiro e último é tempo observado de restauração da escrita controlada pelo script, não RTO percebido pelo usuário. Exclui detecção de falha, timeout do pedido, balanceador, DNS, retries, aquecimento e distância de rede. Teste end-to-end deve começar numa requisição da aplicação e identificar primeira operação de negócio bem-sucedida no endpoint equivalente ao de produção [1].
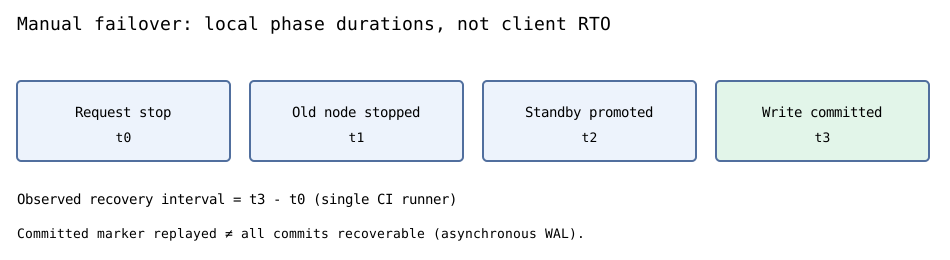
Meça etapas sem confundir relógio de parede#
O helper executável failover_metrics.py armazena timestamps, verifica ordenação e devolve durações da parada, promoção, primeira escrita e restauração total observada. Usa `time.monotonic()` para evitar que alterações no relógio de parede distorçam intervalos. Não compara relógios de máquinas diferentes nem presume sincronização de hosts.
def fases_medidas(inicio, parada, promocao, escrita):
    instantes=(inicio,parada,promocao,escrita)
    if any(b<a for a,b in zip(instantes,instantes[1:])):
        raise ValueError("ordem temporal invalida")
    return {
        "parada_s":parada-inicio,
        "promocao_s":promocao-parada,
        "escrita_s":escrita-promocao,
        "total_s":escrita-inicio,
    }

resultado=fases_medidas(10.0,13.0,16.5,17.0)
assert resultado["parada_s"] == 3.0
assert resultado["promocao_s"] == 3.5
assert resultado["escrita_s"] == .5
assert resultado["total_s"] == 7.0
A suíte inclui casos que recusam timestamps fora de ordem. Produção precisa também avaliar distribuição e percentis após muitas execuções; duração isolada de CI é amostra, não garantia operacional.
Observe ponto reproduzido, não perda zero#
Depois de uma linha de prova confirmar no primário, o script consulta standby até conexão SQL nova devolver exatamente essa linha. Isso fornece evidência positiva de que a transação identificada foi reproduzida. O novo relatório também inclui tempo até observar a linha, mas é afetado por frequência de polling, latência de consulta e escalonamento Python. Não equivale a medição precisa de latência do replay WAL.
Na replicação assíncrona, outros commits posteriores podem não estar disponíveis no standby quando ocorre falha. O marcador comprova um limite inferior do estado recuperado conhecido, não RPO=0 para todas as transações. PostgreSQL expõe LSNs de recebimento e replay e estatísticas para diagnóstico mais fino, mas diferença de bytes entre LSNs não corresponde diretamente a contagem de transações de negócio perdidas [2][3].
Injete partição sem fencing antes de promover#
O laboratório agora remove o primário ainda executando da bridge Docker, mantendo o processo vivo. Por meio do runtime do container, executa escrita numa tabela temporária desse PostgreSQL isolado. A operação mostra que perda de comunicação entre peers não elimina automaticamente autoridade local de gravação. A bridge é reconectada ao mesmo processo; a linha de teste anteriormente confirmada continua disponível na réplica.
É experimento controlado, não partição de produção. Docker `exec` acessa o container pelo daemon, independente da rede do banco. Uma aplicação real pode utilizar outra rota ao primário isolado. Ainda assim, o contraexemplo é concreto: timeout de health check ou replicação não é fencing e não autoriza promoção por si só.
Exija parada do escritor antigo antes da troca#
Depois da recuperação da rede, o teste chama gate que recusa promoção enquanto Docker informa que primário antigo executa. Apenas parada controlada comprovada por nova verificação permite `pg_promote` no standby. Depois confirma que modo de recuperação terminou, grava registro novo e consulta ambas as linhas.
A exigência de verificar escritor antigo difere de comprovar atualização do novo candidato. Failover automático completo necessita fencing independente, coordenação de liderança, epochs persistentes e convergência de roteamento dos clientes. Conferir estado de Docker é fraco perante fencing de energia ou autoridade de consenso bem projetada, pois outro controlador poderia reiniciar primário logo depois.
Registre os tempos em saída estruturada#
Após a escrita confirmada, o script gera linha iniciada por `POSTGRES_FAILOVER_METRICS`, seguida de JSON com `stop_s`, `promotion_s`, `new_write_s`, `observed_recovery_s` e `marker_replay_observed_s`. O campo `scope` descreve alcance do experimento, impedindo que números sejam confundidos com SLA.
import json

amostra={
    "stop_s":1.2, "promotion_s":.3, "new_write_s":.05,
    "observed_recovery_s":1.55, "marker_replay_observed_s":.4
}
serializada=json.dumps(amostra,sort_keys=True)
decodificada=json.loads(serializada)
assert decodificada["observed_recovery_s"] == 1.55
assert decodificada["stop_s"]+decodificada["promotion_s"]+decodificada["new_write_s"] == 1.55
São números ilustrativos do formato JSON, não durações observadas no GitHub Actions. Consulte log verdadeiro do pipeline para medições. Comparações de CI exigem workloads e ambientes equivalentes; runner compartilhado sujeito a ruído não substitui laboratório de benchmarking dedicado.
Interprete modos de falha e promoção#
| Observação | Interpretação válida | Extrapolação indevida |
|---|---|---|
| Marcador aparece no standby | Aquela transação foi reproduzida | Garantia para todos os commits |
| Primário aceita escrita local isolado | Processo continua gravável | Todos os clientes o alcançam |
| Docker confirma primário parado | Teste exclui esse escritor | Fencing independente de produção |
| `pg_promote` termina | Standby sai do recovery | Aplicações redirecionadas |
| Novo INSERT confirma | Banco promovido permite gravações | RTO do cliente satisfeito |
| Tempo decorrido informado | Uma amostra do CI | RTO p99 ou SLA de produção |
Uma escrita falha de um cliente também não prova servidor indisponível: autenticação, roteamento, isolamento, conflito transacional e sobrecarga podem impedir progresso com banco ativo.
Trade-offs de RPO/RTO e alternativas#
Replicação síncrona pode fortalecer condições de confirmação remota do commit, mas elevar latência e impedir gravar quando standby necessário está indisponível [2]. Replicação assíncrona evita essa dependência no caminho comum, aceitando janela em que commits confirmados ainda não alcançaram a réplica. A política correta depende do custo de perda contra o custo de atrasar ou rejeitar escrita.
Para serviço de pedidos, tolerar segundos de perda pode ser inaceitável; para índice de busca reconstruível, recuperação pode ser possível. Cada domínio precisa de semântica explícita de falhas, retenção e conciliação. Não converta estatística isolada de PostgreSQL em objetivo de negócio sem nomear quais transações de cliente estão em risco.
Exercícios e verificação#
- Quais etapas faltam na medição de restauração observada no laboratório?
- Desenhe sonda cliente que registra falhas durante failover controlado e estima a interrupção real do atendimento.
- Por que marcador confirmado visível no standby não significa RPO=0 para toda transação?
- Acrescente teste de verificador de fencing falhando e confirme que callback de promoção não pode executar.
- Compare replicação síncrona e assíncrona quando comunicação com standby falha e indique prioridades de negócio.
Capítulos relacionados: Promoção de réplica física, fencing seguro, replicação de banco e resposta a incidentes fundamentam análise [1][2][3].