Escolher armazenamento é decidir com base em padrões de acesso, invariantes e custos operacionais, não votar em SQL ou NoSQL. Banco que recupera documentos isolados rapidamente pode ser autoridade inadequada para invariantes envolvendo contas e estoque. Um esquema relacional muito normalizado, por outro lado, pode introduzir joins caros num serviço global de consultas simples. Primeiro documente operações, frequência, atomicidade, tamanho e tolerância a dados desatualizados [1][2].
Caracterize a carga antes de escolher tecnologia#
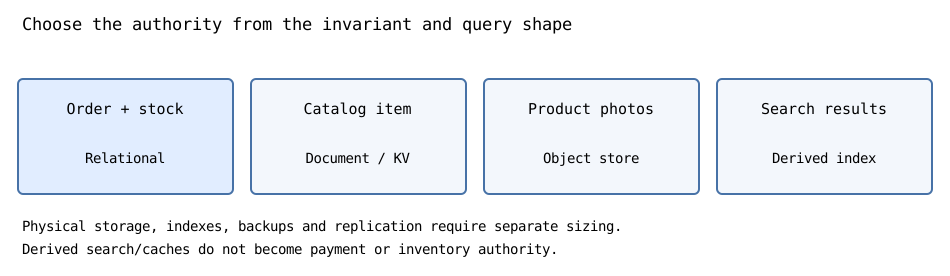
Considere um marketplace hipotético com 500 mil usuários. As operações iniciais são: criar pedido com vários itens; descontar estoque sem sobrevenda; consultar pedido por ID; listar pedidos recentes de um usuário; consultar produtos; e guardar fotografias. Essas operações têm formas distintas. Criar pedido exige atomicidade entre registros numa autoridade; imagens são blobs grandes; busca textual pode se beneficiar de índice especializado.
Para cada consulta, registre chaves de filtro, ordenação, limite de página, p95 esperado, proporção leitura/escrita, pico e consistência. Banco suportar determinada representação não prova que atende a carga com eficiência. Índices, cardinalidade, chaves quentes e custos observados importam [1].
Banco relacional e invariantes transacionais#
Um banco relacional costuma ser ponto inicial defensável como fonte da verdade de pedidos. Oferece chaves, constraints, consultas estruturadas e isolamento de transações. Sob uma única autoridade de banco, uma transação pode criar pedido, linhas, reserva de estoque e mensagem outbox atomicamente, desde que esquema e isolamento imponham invariantes. Isso não coloca API externa de pagamento na mesma transação ACID.
Uma proposta contém orders(id, owner_id, state, created_at), order_lines(order_id, sku, quantity, unit_price), stock(sku, available, reserved) e outbox(id, order_id, kind). Chaves estrangeiras protegem relações; UNIQUE(owner_id, client_key) ajuda na deduplicação durável. Índice (owner_id, created_at DESC, id DESC) suporta paginação por cursor. Atualizar estoque precisa verificar disponibilidade dentro da escrita, não confiar apenas numa leitura anterior obsoleta [2].
Motores SQL diferem em isolamento padrão e bloqueios. Consulta válida em snapshot ainda pode sofrer perda de atualização ou serialization failure se mal projetada. Teste transações reais no banco escolhido; dicionário em memória ou unit test sem conexões concorrentes não comprova essas garantias.
Documentos e fronteira do agregado#
Banco de documentos pode representar catálogo com atributos variáveis num único documento, favorecendo consultas que devolvem o item completo. Isso não significa que qualquer estrutura aninhada deva ficar embutida. Guardar histórico de pedidos crescente dentro de documento do usuário pode gerar registros ilimitados e reescritas caras; referências e documentos separados podem facilitar crescimento e paginação.
Alguns bancos de documentos oferecem transações entre documentos; outros enfatizam operações locais à partição. A palavra 'documento' não define consistência. Confira escopo atômico, manutenção de índices secundários, pré-condições de escrita, lag de réplica e plano de consulta do produto real. A fronteira de agregado acompanha invariantes e atualizações, não formato JSON arbitrário.
Chave-valor e modelagem a partir de consultas#
Bancos chave-valor se destacam quando o cliente conhece chaves ou pode compor consultas suportadas por chave de partição e ordenação. DynamoDB documenta explicitamente modelagem a partir de padrões de acesso, chaves de alta cardinalidade e sort keys para coleções de itens [1]. Listar pedidos recentes de um usuário pode usar partição derivada de usuário e chave de ordem cronológica; listar todos os pedidos de todos os usuários requer outro acesso ou índice.
Uma chave muito quente ainda pode saturar partição quando há capacidade global sobrando. Índices secundários também consomem capacidade de escrita. Um cache chave-valor como Redis não equivale automaticamente a banco durável autoritativo, e um serviço gerenciado durável não é só cache com memória maior.
Blobs, busca e modelos derivados#
Imagens e anexos grandes normalmente pertencem a object storage, com metadados e referência no banco autoritativo. A semântica de objetos difere de constraints de linhas relacionais: gravar arquivo e fazer commit de tabela geralmente não é uma transação única. Use processo em etapas, limpeza de objetos abandonados e acesso assinado/autorizado, evitando URLs públicas para conteúdo privado.
Busca full-text é outra carga. Um índice de busca fornece análise de termos, relevância e filtros, mas costuma ser modelo de leitura atualizado eventualmente, não única fonte para estado de pagamentos. Planeje reconstrução a partir do log/outbox e monitore frescor, sem prometer busca imediata após toda escrita confirmada.
Dimensione armazenamento e amplificação de escritas#
Para hipotéticos 100 mil pedidos/dia com 2 KiB de dados lógicos por pedido, crescimento bruto anual é cerca de 69,6 GiB antes de índices, WAL, réplicas, backups e metadados. Se uma operação modifica linha e três índices secundários, o trabalho físico pode superar muito o tamanho do payload; o fator real depende de benchmark. O exemplo calcula bytes lógicos brutos, não compromisso de capacidade.
def crescimento_gib(registros_por_dia, bytes_por_registro, dias=365):
    if min(registros_por_dia, bytes_por_registro, dias) < 0:
        raise ValueError("entradas negativas")
    return registros_por_dia * bytes_por_registro * dias / (1024 ** 3)

gib = crescimento_gib(100_000, 2048)
assert 69 < gib < 70
assert crescimento_gib(0, 2048) == 0
try:
    crescimento_gib(-1, 2048)
    assert False
except ValueError:
    pass
Planeje também IOPS de pico, rajadas, proporção leitura/escrita, seletividade de índices, retenção, compressão, recuperação e preço de capacidade reservada. O resultado muda com mais itens por pedido ou atributos maiores. Crescimento de bytes e vazão de requisições são cálculos diferentes.
Matriz de decisão para marketplace#
| Requisito | Primeira opção plausível | Motivo para reavaliar |
|---|---|---|
| Pedido com regra de estoque | Banco relacional transacional | Limite medido de escala/geografia |
| Atributos variáveis do catálogo | JSON relacional ou documentos | Joins/transações complexas |
| Lookup exato em altíssima escala | Chave-valor gerenciado | Filtros imprevisíveis ou hotspots |
| Fotos dos produtos | Object storage | Ausência de atomicidade com tabelas |
| Busca ranqueada | Índice de busca derivado | Reconstrução e frescor |
| Leitura de produto popular | Cache | Invalidação e staleness |
São hipóteses iniciais, não prescrições de produtos. Um banco relacional com JSON pode atender catálogo e pedidos na primeira versão, reduzindo custos operacionais. Mover invariantes entre tecnologias introduz fronteira de consistência assíncrona que precisa ser justificada por benefício mensurável.
Migração, falhas e contraexemplos#
Migrar dados da autoridade relacional para nova tecnologia não é apenas trocar implementação de repositório. Defina fonte da verdade, backfill, captura ordenada de mudanças, validação, corte, rollback e política de exclusão. Dual writes podem divergir quando uma operação confirma e outra expira. Com réplica assíncrona, busca ou leitura pode devolver dado velho após criação confirmada.
Evite frases genéricas como 'NoSQL escala automaticamente', 'SQL não permite sharding' ou 'consistência eventual é sempre aceitável'. A implementação e a carga podem refutar cada afirmação. O sistema adequado é o menor que cobre os invariantes do produto na escala medida.
Exercícios e verificação#
- Monte tabela de acessos para criar pedido, atualizar estoque, listar pedidos de usuário e buscar produtos, com índices e transações.
- Por que upload de foto e commit SQL não são automaticamente atômicos entre serviços?
- Recalcule crescimento bruto para 250 mil registros/dia de 1,5 KiB e distinga GiB de GB.
- Construa contraexemplo no qual hash de ID de pedido melhora lookup, mas prejudica listagem cronológica de um usuário.
- Defina métrica que justificaria motor de busca separado em vez da busca do banco SQL.
Capítulos relacionados: Método de System Design, consistência transacional, planejamento SQL e sharding detalham os fundamentos.