Uma plataforma de notificações é um ótimo estudo completo de System Design porque combina preferências, identidade durável de eventos, tarefas assíncronas, provedores externos, retries, quotas e confirmação observável. A pergunta difícil não é qual fila escolher: é o que significa sucesso e quais invariantes permanecem quando um consumidor cai depois que o provedor externo já aceitou a mensagem. O estudo é hipotético e não descreve implementação de uma empresa específica [1][2].
Requisitos de produto e exclusões#
Suponha que aplicações enviem um evento para usuário por API autenticada. O serviço pode enviar email e push segundo preferências do usuário. Clientes consultam status pelo identificador do evento. Exija que tenants não acessem dados alheios, eventos confirmados não sejam perdidos sob o modelo de falha escolhido, tentativas sejam limitadas e canais com opt-out parem de ser usados. Edição avançada de templates e analytics de marketing ficam fora do escopo.
Defina sucesso por etapa: aceito significa requisição e evento persistidos; enfileirado significa tarefa durável por canal; aceito pelo provedor significa acknowledgment externo; recebido pela pessoa pode não ser observável. Não confunda aceitação por provedor com email lido ou push visto. Cada canal tem resultado separado do status agregado do evento.
SLOs e hipóteses de carga#
Considere um milhão de eventos/dia, dois canais por evento em média e pico 20× a média diária. São números hipotéticos do exercício, não métricas reais. Isso dá cerca de 11,57 eventos/s médios e 231,48 eventos/s no pico; tarefas de entrega são aproximadamente 23,15/s em média e 462,96/s no pico antes dos retries. Se um worker sustenta medidos 40 envios/s para essa mistura de provedores, doze workers cobrem o pico sob distribuição ideal; o décimo terceiro fornece capacidade N+1 dos workers, não disponibilidade dos provedores.
Um objetivo ilustrativo seria: 99% das notificações aceitas e elegíveis com provedor disponível dentro de seus limites contratuais recebem acknowledgment em até cinco minutos. Destinos inválidos exigem tratamento explícito; não esconda indisponibilidade de provedor simplesmente excluindo-a. O SLO completo deve ser acordado e medido desde aceite até resposta externa [3].
Arquitetura e autoridades#
O caminho é cliente → API autenticada → banco transacional de evento e outbox → relay do outbox → broker durável → workers → provedores email/push. Consulta de status acessa banco ou modelo de leitura derivado. Preferências definem canais permitidos, e templates seguem política explícita para dados privados.
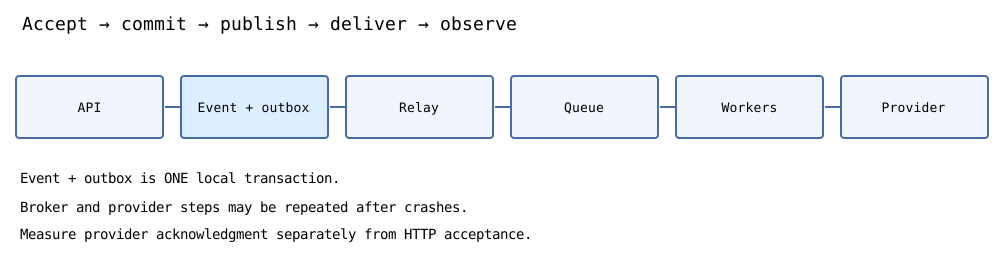
O banco de eventos é a autoridade para identidade aceita e intenção inicial de entrega. Confirmação do broker não substitui commit do banco. Gravar evento e outbox na mesma transação local garante ambos ou nenhum. O relay pode publicar posteriormente. Se publicar e cair antes de marcar progresso, talvez publique novamente; consumidores precisam tolerar duplicatas [1][2].
Contratos de API e chaves duráveis#
POST /v1/notifications pode receber referência de usuário, tipo de evento, variáveis de template e ID da operação do cliente. Autentique tenant e confira que usuário pertence ao escopo; limite tamanho e rejeite canais não suportados. Defina UNIQUE(tenant_id, client_operation_id) e fingerprint de corpo para separar retry de nova intenção. Devolva 202 com ID do evento e rota GET /v1/notifications/{id} após aceitação durável se o processamento for assíncrono.
A chave lógica de entrega é (event_id, channel). Se o provedor oferece token de idempotência por requisição, utilize-o conforme contrato. Se cliente repete depois de timeout, a API recupera evento já persistido em vez de gerar outro. Mesma chave com payload diferente deve produzir conflito documentado.
Modelo de dados e estados#
Uma proposta relacional contém Event(id,tenant_id,user_id,type,status,created_at,client_key,fingerprint), Delivery(event_id,channel,state,attempts,next_attempt_at,provider_ref,lease_token) e Outbox(id,event_id,payload,published_at). Índice único protege Event(tenant_id,client_key) e outro Delivery(event_id,channel). Evite segredos e dados pessoais de templates em logs ou broker não controlados.
Entrega passa por pending → leased → provider_accepted ou leased → retry_wait → leased, encerrando em permanent_failure quando a política esgota tentativas ou recebe falha definitiva. Lease precisa expirar e usar token de fencing ou equivalente, caso contrário worker atrasado pode gravar estado obsoleto. Cancelamento e opt-out exigem prioridade explícita: canal desativado não deve continuar enviando só porque já estava na fila.
Idempotência de worker em modelo local executável#
O código demonstra deduplicação lógica, não entrega externa exatamente uma vez. Usa conjunto local de resultados aceitos por (evento,canal). Um worker real persiste estado em transação e trata disputas de lease e respostas ambíguas de provedores.
class ModeloLocalEntrega:
    def __init__(self):
        self.aceitos = set()
        self.chamadas_provedor = []

    def entregar(self, evento, canal, permitido=True):
        if canal not in {"email", "push"}:
            raise ValueError("canal desconhecido")
        chave = (evento, canal)
        if chave in self.aceitos:
            return "ja_aceito"
        if not permitido:
            return "suprimido"
        self.chamadas_provedor.append(chave)  # Provedor simulado.
        self.aceitos.add(chave)
        return "aceito"

modelo = ModeloLocalEntrega()
assert modelo.entregar("e1", "email") == "aceito"
assert modelo.entregar("e1", "email") == "ja_aceito"
assert modelo.entregar("e1", "push") == "aceito"
assert modelo.entregar("e2", "push", permitido=False) == "suprimido"
assert modelo.chamadas_provedor == [("e1","email"),("e1","push")]
As ações chamadas_provedor.append e aceitos.add não são atomicamente vinculadas. Uma queda depois da aceitação externa e antes de persistir sucesso cria resultado desconhecido. Retry pode enviar novamente sem idempotência no provedor ou reconciliação segura. UNIQUE local previne intenção duplicada no banco, mas não necessariamente entrega externa repetida [2].
Backlog e cálculo da recuperação#
Se o provedor não consegue receber por 20 minutos enquanto chegam 463 tarefas/s, o backlog aumenta em cerca de 555.600 tarefas, ignorando retries. Após recuperação, se os workers processam com segurança 600 tarefas/s, a margem para drenar é 600−463=137 tarefas/s caso a chegada continue no pico. Limpar backlog leva aproximadamente 4.056 segundos, 67,6 minutos, com taxas constantes e sem novas falhas. Assim indisponibilidade breve pode gerar atraso superior a uma hora [1].
from math import ceil

def recuperar_fila(entrada_rps, segundos_pane, capacidade_rps):
    if entrada_rps < 0 or segundos_pane < 0 or capacidade_rps <= entrada_rps:
        raise ValueError("margem de recuperacao insuficiente")
    pendencias = entrada_rps * segundos_pane
    return pendencias, ceil(pendencias / (capacidade_rps - entrada_rps))

pendencias, segundos = recuperar_fila(463, 20 * 60, 600)
assert pendencias == 555600
assert segundos == 4056
try:
    recuperar_fila(463, 1200, 400)
    assert False
except ValueError:
    pass
É cenário de fluxo médio contínuo, não distribuição de latências de teoria das filas. Quotas reais dos provedores, jitter, prioridades por tenant e chegada variável afetam recuperação. Mitigue com limitação de entrada, capacidade reservada a mensagens urgentes, isolamento de filas por prioridade/tenant, deduplicação antes da fila e descarte/expiração somente com política aprovada pelo produto.
Falhas e invariantes observáveis#
| Falha | Resposta segura | Teste |
|---|---|---|
| API cai antes do commit | Evento não aceito; retry cria | Chave repetida |
| API cai após commit | Recuperar evento no retry | Constraint e fingerprint |
| Relay publica duas vezes | Consumidor deduplica entrega lógica | Injetar broker duplicado |
| Provedor aceita e resposta some | Resultado ambíguo; reconciliação/idempotência | Simular timeout após efeito externo |
| Tenant satura fila | Isolamento e admissão justos | Lag por tenant |
| Usuário desativa canal | Checar política efetiva antes de enviar | Corrida de opt-out |
| Worker cai com lease | Recuperar lease com fencing | Crash e failover |
Fila global pode permitir que tenant ruidoso atrase todos. Mas uma fila por tenant pode custar caro com cardinalidade alta; agrupamento e shuffle sharding precisam ser avaliados conforme metas de isolamento. Tentativas pelo menos uma vez e efeitos idempotentes são mais defensáveis que promessa não demonstrada de exactly once global.
Capacidade, custos e observabilidade#
Estime armazenamento do broker por tamanho de mensagem × quantidade retida, separadamente de linhas de evento/status. Conte retries como tentativas, não somente mensagens distintas: tráfego externo e custo crescem com tentativas. Acompanhe aceite de eventos, atraso de commit até criação da tarefa, idade mais antiga em fila, tentativas por entrega, timeout por provedor, p95/p99 fim a fim até aceitação externa, supressões e falhas permanentes.
HTTP 202 bem-sucedido pode coexistir com workers inoperantes. Por isso SLO deve medir resultado do negócio, não apenas respostas HTTP. Revisão do desenho define responsáveis por drenagem de filas, quotas, templates, segredos e incidentes de privacidade.
Exercícios e verificação#
- Recalcule pico de tarefas e número de workers quando canais médios caem de dois para um.
- Por que outbox resolve lacuna banco→broker, mas não torna entrega de email exatamente uma vez?
- Trace crash antes do commit do outbox e crash após aceite do provedor antes da persistência de sucesso.
- Derive os 67,6 minutos; diga por que o cálculo não vale quando provedor limita taxa a 500 tarefas/s.
- Proponha testes de isolamento por tenant e opt-out com eventos duplicados, backlog e entrega atrasada.
Capítulos relacionados: Método de System Design, mensagens assíncronas, contratos HTTP e capacidade dão o suporte conceitual.