Rate limiting determina se uma requisição pode consumir um recurso limitado agora. Ajuda a conter abuso, proteger capacidade e aplicar cotas de API. É diferente de limitar concorrência (operações em andamento), balancear carga (roteamento) e backpressure (redução do ritmo dos produtores). Mesmo respeitando uma cota de requisições por segundo, um serviço pode sobrecarregar se cada operação ficar mais cara.
Defina o contrato antes do algoritmo#
Especifique a chave de identidade (conta, API key, tenant ou IP), a unidade de custo (requisição, token ou peso computacional), o intervalo, a capacidade de rajada e o comportamento da rejeição. IP isolado pode ser fraco: muitos usuários legítimos compartilham endereço via NAT e agentes abusivos podem alterná-lo. Prefira identificadores autenticados quando disponíveis e crie regra separada para clientes anônimos.
O status HTTP 429 Too Many Requests informa requisições demais de um usuário em um período. A RFC 6585 não impõe técnica específica de contagem e permite o cabeçalho Retry-After para orientar novas tentativas [1].
Algoritmos e diferenças#
| Método | Estado | Vantagem | Limitação |
|---|---|---|---|
| Janela fixa | Contador e janela atual | Simples e limitado | Rajadas na virada da janela |
| Log deslizante | Timestamps recentes | Cota móvel exata | Memória proporcional aos registros |
| Contador deslizante | Contagens de janelas adjacentes | Estado limitado | Erro de aproximação |
| Token bucket | Tokens e instante de reposição | Taxa e rajada explícitas | Exige atomicidade e política de relógio |
Por exemplo, janela fixa de dez chamadas por minuto pode aceitar dez requisições às 00:59,9 e outras dez às 01:00,1. O cliente envia vinte requisições em fração de segundo sem violar nenhuma das janelas. Uma contagem móvel real de sessenta segundos rejeitaria parte do agrupamento.
Dedução do invariante do token bucket#
Seja B a capacidade máxima em tokens, r a reposição por segundo, t o tempo atual e last o último instante de atualização. Antes de admitir, faça tokens = min(B, tokens + r × (t-last)). Aceite custo c somente quando tokens for pelo menos c e então subtraia c. Com tempo monótono e operações serializadas, tokens permanece entre zero e B. Em intervalo de duração T, o trabalho admitido não supera B + rT sob um bucket autoritativo.
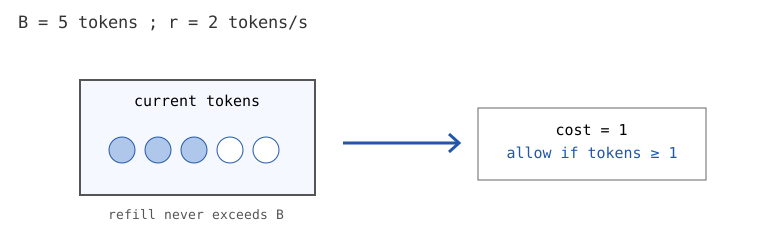
Com B=5, r=2 tokens/s e custo unitário, cinco requisições simultâneas passam e a sexta falha. Após meio segundo, um token retorna. Capacidade cinco representa rajada instantânea de cinco, não cinco requisições por segundo.
class BaldeTokens:
    def __init__(self, capacidade, taxa):
        if capacidade <= 0 or taxa <= 0:
            raise ValueError('capacidade e taxa positivas exigidas')
        self.capacidade = float(capacidade)
        self.taxa = float(taxa)
        self.tokens = float(capacidade)
        self.ultimo = 0.0

    def permitir(self, agora, custo=1):
        if custo <= 0 or custo > self.capacidade or agora < self.ultimo:
            raise ValueError('custo ou tempo invalido')
        self.tokens = min(self.capacidade, self.tokens + (agora-self.ultimo)*self.taxa)
        self.ultimo = agora
        if self.tokens < custo:
            return False
        self.tokens -= custo
        return True

b = BaldeTokens(5, 2)
assert all(b.permitir(0) for _ in range(5))
assert not b.permitir(0)
assert b.permitir(0.5)
assert not b.permitir(0.5)
Este é um modelo didático sequencial, não pronto para threads ou distribuição. A operação de leitura, cálculo e atualização deve ser atômica quando há trabalhadores compartilhando o mesmo bucket.
Estado distribuído e política de falhas#
Se dez servidores independentes aplicam 100 requisições/s para o mesmo cliente, esse cliente pode conseguir perto de 1.000 requisições/s globalmente. Limite local não equivale a cota global. As opções incluem gateway central, armazenamento compartilhado com operação atômica ou orçamentos explicitamente distribuídos por região ou instância. Estado compartilhado custa latência, contenção e decisões em indisponibilidade: fail open aceita tráfego excedente quando o armazenamento falha; fail closed rejeita inclusive tráfego legítimo. A escolha depende do endpoint.
Relógios monótonos são adequados dentro de um processo, mas não podemos comparar de maneira ingênua os instantes de hosts distintos. Ler e depois gravar contador compartilhado pode fazer dois workers admitirem o último token. Use operação transacional ou atômica executada no servidor. NGINX implementa limite por mecanismo semelhante a leaky bucket, com rajadas, atrasos e rejeições configuráveis; sua semântica exata não é igual à deste modelo didático [2].
Operação e verificação#
Padronize resposta 429 e opcionalmente Retry-After, exigindo clientes com espera exponencial limitada e jitter. Diferencie operações caras de leituras baratas quando necessário. Monitore aceitas e rejeitadas, concentração por tenant, saturação de backends, falhas do armazenamento e latências p95/p99. Rate limiting não substitui autenticação, autorização nem limitação de concorrência.
Demonstração do limite superior do token bucket#
Seja b(t) a quantidade de tokens, B a capacidade, r tokens/s a reposição e trabalho admitido medido nas mesmas unidades. Entre t0 e t1, o trabalho aceito não supera B+r(t1−t0) sob um único bucket serializado: no início existem no máximo B tokens e a reposição acrescenta no máximo rΔt. Isso não impõe limite instantâneo rígido de requisições por segundo: uma rajada B pode passar de uma vez. Use semáforo de concorrência ou controle de trabalhos ativos se a duração das operações também puder saturar os recursos.
Comparação das janelas e dos modelos#
O contador de janela fixa reinicia nos limites temporais e pode permitir quase duas cotas em intervalo curtíssimo próximo à virada. O log deslizante armazena timestamps e impõe contagem móvel exata ao custo de mais estado. O token bucket permite acumular créditos até B. Um leaky bucket com fila escoa trabalho a uma taxa controlada, mas pode acrescentar latência ou descartar após encher. Produtos chamam mecanismos específicos de 'leaky bucket'; verifique a semântica real em vez de presumir que as equações coincidam [2].
Atomicidade e limite distribuído#
Considere um contador compartilhado com um token restante; duas instâncias leem simultaneamente o mesmo valor. Se cada uma subtrai por etapas separadas de leitura e escrita, ambas podem admitir a operação, ultrapassando a cota. Use transição atômica no servidor ou transação e documente a origem do relógio. Dividir cota entre nós reduz coordenação, mas gera problemas de transferência de orçamento e equidade quando o tráfego se distribui mal. Fail open preserva disponibilidade e permite carga excessiva; fail closed pode bloquear clientes legítimos quando o limitador falha.
Com múltiplos limites—IP, usuário e global—defina ordem de avaliação e se uma rejeição também consome outras cotas. Evite revelar identidades por tempo ou detalhe da resposta. Rate limiting não substitui autenticação, autorização, detecção de bots ou garantia de capacidade do backend.
Política HTTP e comportamento do cliente#
HTTP 429 indica excesso de requisições; Retry-After pode informar atraso antes da repetição. O cliente não deve tentar novamente tudo de imediato: retries sincronizados geram novos picos. Prefira backoff exponencial limitado com jitter e prazo máximo, considerando idempotência do comando [1].
POST /v1/operacao-custosa
HTTP/1.1 429 Too Many Requests
Retry-After: 5
Content-Type: application/json

{"error":"rate_limited","retryable":true}
Experimentos necessários#
Use relógio monotônico controlado para testar: rajada inicial B; esgotamento exato; reposição parcial; ociosidade longa sem ultrapassar B; custo fracionário; movimento negativo de tempo inválido; e duas tentativas simultâneas pelo último token. O último caso não é comprovável pela demonstração sequencial em memória: execute-o na implementação atômica compartilhada. Teste também partições regionais e quedas da loja de estado para conferir a política de falhas.
Exercícios e verificação#
- Com B=8 e r=1 token/s, oito chamadas no instante zero esgotam tokens; após três segundos, passam exatamente três requisições unitárias.
- Reconstrua vinte chamadas na virada de janela fixa e explique por que ambos os contadores permanecem válidos.
- Explique por que dez instâncias locais de 100 requisições/s não garantem cota global de 100 requisições/s.
- Altere o código para custo fracionário 2,5. Especifique a operação atômica necessária antes de lidar com clientes concorrentes.