Um balanceador de carga recebe tráfego e escolhe o destino entre várias instâncias de uma aplicação. Não produz capacidade no backend por si só. A capacidade aumenta quando as instâncias podem escalar de modo independente e dependências compartilhadas não se tornam gargalo. A disponibilidade e a configuração do balanceador também integram o modelo de falhas [1][2].
Dedução do dimensionamento#
Considere um pico hipotético de 3.000 requisições por segundo para um serviço HTTP sem estado de sessão local. Testes com mistura representativa de operações indicam 500 requisições por segundo por instância dentro da meta de latência. Seis instâncias atenderiam apenas com utilização total. Limitando a utilização planejada a 60%, cada instância contribui com 500 × 0,60 = 300 requisições por segundo. Portanto, precisamos de pelo menos ceil(3000/300) = 10 instâncias saudáveis. Para suportar a falha de uma sem ultrapassar a mesma meta de utilização, provisionamos 11: dez permanecem ativas.
Os valores são premissas de exemplo, não constantes do setor. O dimensionamento real depende da capacidade do banco, latência de filas, memória, rede e rajadas de tráfego. Consulte Estimativas de capacidade para diferenciar requisições por segundo e concorrência.
Algoritmos de encaminhamento#
| Política | Regra | Vantagem | Limitação |
|---|---|---|---|
| Round robin | Alterna entre destinos | Simples para máquinas semelhantes | Ignora requisições lentas |
| Round robin ponderado | Favorece conforme pesos | Adapta-se a servidores diferentes | Pesos podem ficar defasados |
| Menos conexões | Escolhe menor contagem de conexões ativas | Ajuda com tempos de atendimento diferentes | Conexões não medem trabalho de CPU |
| Hash por IP | Associa endereço a instância | Aproxima afinidade de sessão | NAT distorce cargas; mudanças quebram afinidade |
NGINX documenta round robin, menos conexões, hash por IP, pesos e verificações passivas de saúde [1]. Cada política aproxima a carga de maneira diferente; somente medições com tráfego representativo revelam seu resultado.
Estado de sessão e semântica de requisições#
Um backend stateless não deveria exigir que as requisições sucessivas de um usuário cheguem à mesma máquina. Sessões compartilhadas podem ficar em armazenamento externo adequado, ou credenciais podem conter declarações assinadas. Sessões sticky ajudam algumas aplicações legadas, mas dificultam substituir servidores falhos. Balanceadores de aplicação trabalham na camada HTTP e podem encaminhar por host ou rota; balanceamento de transporte usa informações das conexões [2].
Não repita cegamente uma requisição após timeout. Um POST de pagamento pode confirmar uma transação e perder apenas a resposta. Repetir sem idempotência pode cobrar duas vezes. Defina prazo fim a fim, orçamento de retentativas e espera exponencial com jitter. Durante uma falha geral, retries podem multiplicar a demanda justamente quando a capacidade diminui.
Verificações, drenagem e observabilidade#
Separe liveness (processo responde), readiness (deve receber tráfego) e saúde real das dependências. Se todas as sondagens de readiness falham porque o mesmo banco caiu, o balanceador pode remover todas as instâncias. Use limiares para evitar alternância constante. Durante deploy, suspenda atribuições novas, permita que operações em andamento terminem dentro de prazo limitado e só então finalize a instância. NGINX documenta verificações passivas; detalhes de verificações ativas variam entre produtos e edições [1].
Monitore tráfego por backend, conexões, proporção de erros, latências p95/p99, saturação e número de retries. Distribua serviços entre domínios de falha independentes quando possível. Confie em cabeçalhos de IP encaminhado somente quando definidos por proxy verificado; caso contrário, atacantes podem falsificar identidade. Estabeleça o comportamento quando não restar instância saudável.
Limites arquiteturais#
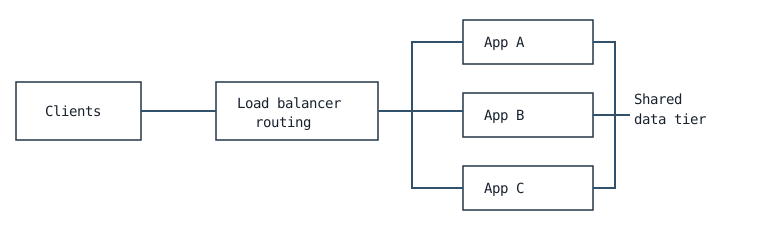
Cliente -> DNS -> balanceador -> app A / app B / app C
                                  |       |       |
                                  +-------+-------+--> dados compartilhados
Adicionar réplicas da aplicação não resolve o gargalo de um único banco de dados. O balanceador também não garante correção de escritas concorrentes; consulte Consistência transacional. Dimensione o armazenamento para a demanda agregada e as rajadas provocadas por retentativas.
Políticas de roteamento e comportamento das filas#
Round robin distribui requisições em sequência, mas pressupõe custos e capacidades aproximadamente iguais. Weighted round robin representa diferenças conhecidas de capacidade, sem refletir necessariamente saturação instantânea. Least connections envia trabalho ao nó com menos conexões ativas; pode enganar quando conexões estão ociosas ou multiplexam múltiplas requisições. Políticas baseadas em latência usam feedback, mas podem oscilar ou concentrar carga conforme ruído das medições. A escolha do algoritmo depende do trabalho real, não de um ranking universal [1].
Diferencie roteamento de camada 4 (conexões e transporte) de camada 7 (método HTTP, rota, cabeçalhos, host e cookies). TLS pode terminar no gateway ou ser encaminhado; isso altera posse de certificados, observabilidade e fronteiras de confiança. Nunca confie automaticamente num cabeçalho de IP de cliente se a cadeia de proxies não for autenticada.
Sessões e drenagem de conexões#
Uma aplicação sem estado pode encaminhar requisições sucessivas do mesmo usuário a instâncias diferentes porque a sessão reside num componente persistente/compartilhado apropriado, ou porque carrega estado autossuficiente validado. Sticky sessions preservam estado em memória por algum tempo, mas complicam failover e desequilibram usuários muito ativos; não substituem modelo deliberado de sessão.
Ao retirar um nó, pare primeiro de admitir novas requisições e permita que as existentes terminem até um prazo máximo. Protocolos exigem semânticas diferentes: um WebSocket pode durar horas, um HTTP comum milissegundos. Uma instância pode aprovar teste TCP e falhar na lógica da aplicação; use readiness para roteamento e política distinta para liveness do processo.
Health checks e falhas correlacionadas#
Para N instâncias saudáveis com capacidade C requisições/s cada, na latência exigida, capacidade aproximada é N×C; porém dependências compartilhadas, como banco saturado, invalidam a hipótese de nós independentes. Testes ativos detectam falhas previstas; observação passiva usa tráfego real, mas pode reagir tarde ou marcar todos os nós como ruins numa pane comum. Repetições descontroladas no gateway podem agravar o incidente.
Um único load balancer também é domínio de falha. Redundância pode exigir múltiplos gateways e estratégia de DNS, anycast ou failover gerenciado. Um teste bem-sucedido de failover verifica convergência de rota e comportamento dos clientes, não apenas alcance ao segundo gateway [2].
Dimensionamento e observabilidade#
Para pico de 3.000 RPS e 500 RPS de capacidade máxima medida por instância, operar a 60% produz alvo de 300 RPS por nó; dez nós cobrem pico e onze toleram uma falha sob o mesmo alvo. Mas se 20% das operações gastam cinco vezes mais CPU que as demais, RPS agregado esconde a alteração de custo. Meça carga por endpoint, RPS concluído, p95/p99, erros, operações simultâneas e saturação.
| Falha | Sintoma | Resposta |
|---|---|---|
| Instância para | 5xx/erros de conexão | Health checks, orçamento de retries e drain |
| Banco compartilhado falha | Erros correlacionados | Rejeitar excesso em vez de roteamento infinito |
| Sessão só em memória | Perda de sessão no failover | Contrato de sessão compartilhada/persistente |
| Operações lentas dominam conexões | Trabalho desigual apesar de RPS igual | Medir custo e latência por classe de operação |
Revisão: se você multiplica réplicas, quais partes de estado precisam mudar? Se a resposta é 'nenhuma', mas sessões mutáveis continuam na RAM local, a alegação de escalabilidade está incompleta.
Exercícios e verificação#
- Com 2.400 requisições/s, capacidade de 400 por instância e utilização planejada de 50%, ceil(2400/200) = 12 instâncias saudáveis; 13 toleram uma falha.
- Explique quando menos conexões pode ajudar numa mistura de operações de 5 milissegundos e 5 segundos e por que isso não mede uso de CPU.
- Descreva timeout após commit de pagamento. Qual contrato de chave de idempotência permite repetir com segurança?
- Em ambiente de testes, remova um servidor e valide readiness, drenagem, meta de erros e comportamento do banco durante o pico.