A replicação PostgreSQL pode preservar dados num standby e permitir sua promoção, mas não resolve automaticamente eleição de primário, redirecionamento de clientes, prevenção de split brain nem perda de transações. Este laboratório prepara primário e réplica física PostgreSQL 17 em containers Docker separados, cria standby com pg_basebackup -R, verifica que uma linha confirmada foi efetivamente reproduzida, interrompe o primário antigo, promove a réplica e confirma nova escrita. É um componente de failover verificável, não uma plataforma completa de alta disponibilidade [1][2].
Escopo e contrato de falha#
Dois processos PostgreSQL funcionam em containers e volumes separados numa rede Docker isolada. O primário inicial é a única autoridade de escrita; standby é somente leitura enquanto pg_is_in_recovery() retorna verdadeiro. Uma linha com ID um é confirmada no primário e o teste aguarda o mesmo registro aparecer numa consulta da réplica antes de interromper o primário. Essa espera importa: em streaming assíncrono, alteração confirmada pode ainda não ter sido aplicada no standby [2].
A troca de autoridade é manual. Não usamos Patroni, repmgr, serviço externo de eleição nem proxy de failover. A promoção só ocorre depois que o script para o primário antigo, evitando dois escritores na sequência testada. Isso não comprova fencing automático nem protege contra retorno inesperado de servidor em outra partição de rede.
Prepare a réplica física#
O script inicia primário PostgreSQL com wal_level=replica e recursos de WAL sender suficientes para base backup físico. Permite conexões de replicação na rede isolada. Um novo volume recebe cópia de dados por pg_basebackup; com opção -R, ferramenta grava standby.signal e parâmetros de conexão para acompanhar o servidor de origem [1].
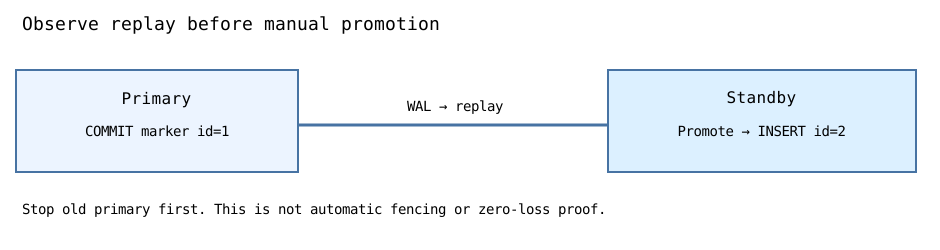
A replicação física trabalha em nível de cluster de banco, não copiando cada chamada HTTP. Registros WAL representam alterações, e replay as torna visíveis quando aplicadas. pg_basebackup exige versão compatível, autenticação correta, permissões de volume, conservação dos segmentos WAL e acompanhamento de atraso de replicação [1][2].
Observe a reprodução, não presuma#
Depois de iniciar standby, o teste exige pg_is_in_recovery() verdadeiro. Cria tabela de prova e insere uma linha no primário. Consulta standby repetidamente até obter payload esperado. Isso é evidência mais forte que apenas porta 5432 aberta ou conexão de replicação estabelecida: comprova que aquela transação específica ficou visível na réplica.
Mesmo assim, não é garantia geral de perda zero. Uma transação posterior pode confirmar no primário assíncrono sem alcançar standby antes de pane súbita. O teste aguarda explicitamente apenas um registro conhecido. Replicação síncrona com condições adequadas de confirmação pode fornecer garantias maiores, mas aumenta custo de latência e pode afetar disponibilidade [2][3].
Interrompa o primário e promova standby#
Depois de observar a linha, o teste executa docker stop no primário. Em seguida chama pg_promote(true, 40) no standby. O retorno positivo indica promoção concluída dentro do limite solicitado; nova consulta a pg_is_in_recovery() deve ser falsa. Outra linha é inserida, comprovando que servidor promovido aceita escrita.
A verificação de ambas importa: primeira comprova dados previamente reproduzidos preservados e segunda comprova nova autoridade gravando transações. Não prova que tráfego foi automaticamente redirecionado nem que aplicação permaneceu disponível durante troca. O laboratório torna interrupção e endpoints explícitos.
Reprodução e evidência no CI#
A fonte scripts/verify_postgres_promotion.py cria containers PostgreSQL 17, executa pg_basebackup verdadeiro, consulta ambos com psycopg, promove standby e limpa containers, volumes e rede com finally. O workflow GitHub Actions executa o teste no runner Docker Linux descartável depois dos testes habituais.
Exige acesso Docker e infraestrutura de testes. Interrompe intencionalmente processo de banco; jamais use contra cluster de produção compartilhado. Credenciais e registros didáticos ficam apenas no CI efêmero, sem dados reais de usuários.
Raciocine sobre commits e atraso da réplica#
Se o primário confirma 100 escritas/s e standby fica dez segundos atrás, aproximadamente 1.000 operações podem estar pendentes para replay, sob essa aproximação com taxa constante. Réplica que aplicou somente parte dessas escritas não representa obrigatoriamente o último estado confirmado do primário.
def escritas_ainda_nao_replicadas(taxa_por_segundo, segundos_atraso):
    if taxa_por_segundo < 0 or segundos_atraso < 0:
        raise ValueError("valores nao negativos obrigatorios")
    return taxa_por_segundo * segundos_atraso

assert escritas_ainda_nao_replicadas(100, 10) == 1000
assert escritas_ainda_nao_replicadas(0, 100) == 0
É aproximação de capacidade, não métrica exata de lag PostgreSQL. O atraso real depende de bytes, rede, produção de WAL e custo do replay. Meça diferenças de LSN de escrita, flush e replay conforme necessidade; não confunda bytes com quantidade de transações [2].
Split brain e fencing são exigências separadas#
Primário real pode ficar inacessível ao controlador de failover enquanto ainda recebe escritas de alguns clientes. Promover réplica nessa partição pode criar dois primários conflitantes, o split brain. Produção exige fencing ou controle equivalente de liderança, impedindo que primário antigo retorne a gravar quando novo primário foi promovido [3].
O primário anterior não deve simplesmente voltar como standby reutilizando timeline e diretório antigos. Reintegração exige preparação a partir do primário novo ou ferramentas de recuperação adequadas, respeitando WAL e históricos de timeline. O exercício remove os volumes temporários em vez de simular reentrada insegura.
Matriz de falhas e revisão#
| Situação | Garantia observada ou exigida | Alcance |
|---|---|---|
| Standby inicia | Informa estado de recuperação | SQL verdadeiro |
| Marcador confirmado no primário | Torna-se visível na réplica | Replay real |
| Primário anterior é parado | Sem dois escritores nessa sequência | Docker stop, sem fencing |
| Standby é promovido | Recuperação termina e INSERT funciona | Promoção real |
| Falha elétrica no primário | Commits ainda não replicados podem faltar | Não testado |
| Partição de rede | Split brain sem fencing possível | Não testado |
| Reconexão automática da aplicação | Exige roteamento e descoberta | Não testado |
Exercícios e verificação#
- Por que base backup concluído não comprova que novos commits já estão reproduzidos?
- Compare condições de commit assíncrono e síncrono e seus efeitos sobre disponibilidade de escrita.
- Proponha fencing seguro e explique o risco mitigado durante promoção.
- Amplie o script para medir diferença de LSN sem confundir tamanho de WAL com contagem de transações.
- Descreva como reintegrar primário antigo após standby receber novas escritas numa timeline diferente.
Capítulos relacionados: Replicação e failover, isolamento, laboratório PostgreSQL e resposta a incidentes fornecem fundamentos [1][2][3].