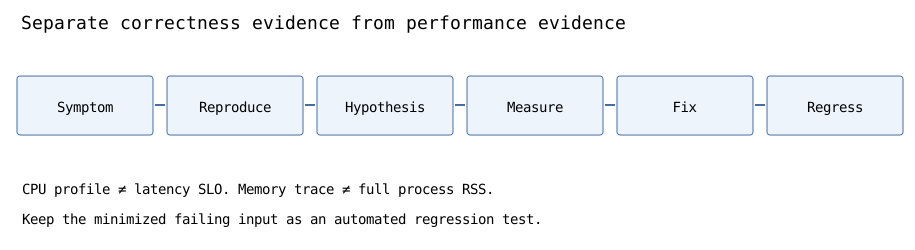
Debugging e profiling respondem perguntas diferentes: debugging explica por que o comportamento viola um contrato; profiling identifica onde a execução gasta tempo ou aloca memória. Devem trabalhar juntos. Otimizar antes de reproduzir defeito pode escondê-lo; investigar endpoint lento por uma linha de log pode levar à reescrita do componente errado. Um método consistente é reproduzir, isolar, formular hipótese, coletar evidência discriminante, corrigir a causa e preservar um teste de regressão [1][2].
Estabeleça falha observável#
Comece pelo sintoma descrito como entrada, saída esperada e resultado real. Imagine função que devolve o primeiro índice cujo valor seja pelo menos um alvo num array ordenado. O contrato inclui entrada vazia (devolver comprimento, zero), duplicatas (primeira ocorrência) e alvo acima do maior valor (devolver comprimento). Se o cliente procura primeiro valor pelo menos 3 em [1,3,3,5], índice 2 está errado, apesar de conter valor 3.
Crie um reprodutor mínimo executável; remova rede, interface e dependências não determinísticas até manter a falha no menor caso. Exemplo mínimo é mais útil que captura de stack trace sem entrada. Registre versão do runtime, forma dos dados e hipóteses de concorrência quando afetam execução.
Localize pelo invariante, não por suposição#
Busca binária mantém intervalo semiaberto [esquerda,direita) que contém a primeira posição satisfazendo a[i] >= alvo. Comece esquerda=0, direita=n. No meio, se a[meio] < alvo, todas as posições até meio são inválidas e esquerda=meio+1. Caso contrário, meio pode ser a resposta e direita=meio. O intervalo diminui; quando esquerda==direita, encontramos o lower bound.
def primeiro_pelo_menos(valores, alvo):
    esquerda, direita = 0, len(valores)
    while esquerda < direita:
        meio = (esquerda + direita) // 2
        if valores[meio] < alvo:
            esquerda = meio + 1
        else:
            direita = meio
    return esquerda

assert primeiro_pelo_menos([], 7) == 0
assert primeiro_pelo_menos([1, 3, 3, 5], 3) == 1
assert primeiro_pelo_menos([1, 3, 3, 5], 4) == 3
assert primeiro_pelo_menos([1, 3, 3, 5], 9) == 4
assert primeiro_pelo_menos([3, 3, 3], 3) == 0
Pressupõe sequência ordenada sob comparação total consistente. Usa O(log n) comparações e O(1) memória auxiliar sob acesso aleatório e comparação de custo constante. Array desordenado quebra o invariante; resultado pode ser qualquer índice. Outro erro—usar <= em vez de <—muda lower bound para upper bound, ignorando chaves iguais.
Construa oráculo independente#
Teste que repete a mesma busca binária pode reproduzir o erro. Compare com varredura linear mais lenta e evidentemente correta em casos curtos. Enumere exaustivamente pequenos arrays não decrescentes e um conjunto de alvos. Isso é checagem limitada de casos, não prova universal; o invariante fundamenta a demonstração geral.
from itertools import combinations_with_replacement

def limite_linear(valores, alvo):
    for i, item in enumerate(valores):
        if item >= alvo:
            return i
    return len(valores)

for tamanho in range(6):
    for tupla in combinations_with_replacement(range(4), tamanho):
        valores = list(tupla)
        for alvo in range(-1, 6):
            assert primeiro_pelo_menos(valores, alvo) == limite_linear(valores, alvo)
Preserve qualquer contraexemplo novo num teste de regressão. Se um bug ocorrer apenas com dados reais, minimize um conjunto sanitizado; nunca copie credenciais ou dados pessoais para fixtures públicas.
Profiling de tempo versus medição de latência#
Profiler mostra onde o código executa; benchmark mede quanto uma carga leva. O cProfile do Python coleta contagens de chamadas e estatísticas de tempo por função, analisáveis via pstats [1]. O relógio time.perf_counter mede tempo decorrido entre instantes, não só CPU; espera de I/O, escalonamento e aquecimento interferem [3].
import cProfile
import pstats
import io
from time import perf_counter

def soma_quadrados(n):
    return sum(x * x for x in range(n))

profiler = cProfile.Profile()
inicio = perf_counter()
profiler.enable()
resposta = soma_quadrados(1000)
profiler.disable()
decorrido = perf_counter() - inicio
relatorio = io.StringIO()
pstats.Stats(profiler, stream=relatorio).sort_stats("cumulative").print_stats(5)
assert resposta == 332833500
assert decorrido >= 0
assert relatorio.getvalue()
Não afirme que uma medição tão pequena representa produção. O próprio profiler acrescenta overhead; compare versões com distribuições de entrada iguais, aquecimento e várias repetições independentes. Em sistemas assíncronos, separe espera em filas, chamadas remotas e contenção de locks do tempo de CPU Python.
Memória crescente e tracemalloc#
RSS crescente não implica necessariamente leak de objetos Python: allocators podem reter memória, caches podem aquecer, bibliotecas nativas alocam buffers e garbage collection interfere. O tracemalloc rastreia alocações gerenciadas pelo Python e permite snapshots e comparações por local [2]. Não explica toda alocação nativa nem prova vazamento sozinho.
import tracemalloc

tracemalloc.start()
buffer = [bytes(128) for _ in range(64)]
atual, pico = tracemalloc.get_traced_memory()
assert atual >= 0 and pico >= atual
assert len(buffer) == 64
tracemalloc.stop()
Para investigar crescimento, repita a operação muitas vezes com entradas controladas, compare snapshots, inspecione tempo de vida dos objetos e depois correlacione com RSS e ferramentas nativas. Snapshot de início e outro após preencher cache podem refletir retenção legítima, não crescimento ilimitado.
Debugging em produção com telemetria#
Logs explicam eventos; métricas quantificam taxas/distribuições; traces distribuídos relacionam trabalho entre serviços. OpenTelemetry documenta esses sinais e métodos de instrumentação [4]. Associe trace ID às requisições e inclua metadados sem dados sensíveis, duração de dependências, número de retries e categoria de erro. Não registre senhas e informações pessoais só para obter visibilidade.
Quando p99 sobe, separe mudança de tráfego, fila, cache frio, plano de consulta, saturação de CPU e dependência externa. Mensagem “timeout” é sintoma, não evidência de onde o deadline foi gasto. Compare traces bem-sucedidos e falhos, versões de deploy e recursos antes de escolher correção.
Loop de correção e rollback#
| Sintoma | Hipótese | Evidência |
|---|---|---|
| Índice errado em duplicatas | Condição de igualdade salta chaves | Fixture mínima e invariante |
| CPU saturada | Algoritmo quadrático | Profile por tamanho de entrada |
| p99 alto com CPU normal | Espera remota ou fila | Traces, profundidade da fila e percentis |
| RSS crescente | Objetos retidos ou buffers nativos | Snapshots, tendências de RSS |
| Erros começaram após release | Código/esquema regressivo | Métricas por versão e rollback |
Um teste aprovado após corrigir não prova que tudo está seguro. Verifique contratos próximos, rode integração na fronteira alterada e compare métricas após publicação. Faça rollback se impacto ultrapassar orçamento de risco e investigue depois.
Exercícios e verificação#
- Mostre por que
valores[meio] <= alvoresponde outra pergunta com duplicatas. - Explique por que o oráculo exaustivo é melhor que dois testes manuais, mas ainda não demonstra entradas ilimitadas.
- Diferencie custo por função no cProfile, tempo de parede no perf_counter e alocações no tracemalloc.
- Proponha experimento seguro para distinguir espera no banco de gargalo de CPU num endpoint.
- Especifique logs, traces, métricas e sinais de rollback que preservaria num incidente de regressão.
Capítulos relacionados: Busca binária, estratégias de testes, resposta a incidentes e observabilidade desenvolvem o método.