Observabilidade é a capacidade de investigar o funcionamento interno de um sistema a partir dos sinais emitidos. Um painel não cria essa capacidade sozinho: é preciso saber que contrato do usuário está sendo medido, como as requisições são correlacionadas e quais falhas a própria coleta pode ocultar. Serviços distribuídos pedem evidências complementares de métricas, logs e traces, ligadas a objetivos de nível de serviço (SLOs) [1][3].
Defina o serviço medido antes dos gráficos#
Comece por um indicador de nível de serviço (SLI), com população e janela definidas. Por exemplo, disponibilidade em 30 dias pode ser requisições HTTP elegíveis bem-sucedidas divididas pelo total de requisições elegíveis. 'Elegível' precisa de definição: excluir health checks ou cancelamentos do cliente altera o denominador. Um SLO é uma meta para o indicador, não promessa de sucesso para toda operação individual.
Os quatro sinais fundamentais do Google SRE são latência, tráfego, erros e saturação [3]. Tráfego pode representar requisições concluídas por segundo, não apenas conexões abertas. A definição de erro segue a semântica do negócio, diferenciando pedido inválido enviado corretamente pelo cliente de falha interna. Saturação pode envolver fila, CPU, disco, pool de conexões ou cota de um serviço externo; utilização de CPU, sozinha, não explica sobrecarga.
Métricas e percentis#
Métricas agregam medidas ao longo do tempo e de dimensões. Um counter normalmente acumula eventos (salvo resets); gauge representa valor instantâneo; histogramas preservam distribuições em intervalos de valores, com regras próprias de agregação. Se um serviço retorna 200 sucessos em 100 ms e 5 falhas em 4 ms, a média combinada oculta o impacto dos erros. Meça separadamente latência de sucessos e falhas, usando fronteira fim a fim acordada [3].
Um percentil é propriedade de uma coleção observada ou distribuição, não média dos percentis por host. Em geral, p99(A)+p99(B) não é p99(fim a fim), porque os pedidos mais lentos em cada etapa podem ser diferentes. Quando há fan-out, a cauda pode depender da operação mais lenta mesmo que as médias pareçam boas. Use traces completos ou histogramas agregados corretamente antes de concluir que o SLO foi atendido.
Traces, spans e causalidade#
Um trace representa operações relacionadas entre serviços. Cada span descreve unidade de trabalho com trace ID, span ID, horário e atributos, eventos ou links opcionais [1]. A especificação W3C Trace Context padroniza os cabeçalhos traceparent e tracestate para propagar identificadores entre componentes [2]. Um gateway HTTP pode criar span raiz, enviar contexto ao worker e correlacionar consulta de banco em outro processo.
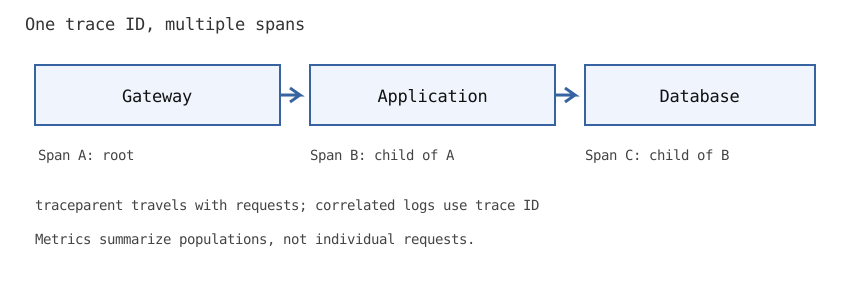
Grafo de trace e pilha de chamadas não são idênticos: uma fila pode continuar um fluxo lógico depois que o pedido HTTP terminou. Links entre spans representam relações causais que não são simples chamadas pai-filho. Propagar por um broker requer extração e injeção do contexto; perder um cabeçalho fragmenta a visão distribuída ainda que cada serviço faça logging local.
Logs, privacidade e cardinalidade#
Logs registram eventos com campos estruturados como timestamp, operação, resultado, trace ID e tipo de erro. São mais úteis quando se correlacionam a spans e versões do serviço. Não registre tokens bearer, senhas ou corpos sensíveis sem tratamento. OpenTelemetry baggage pode transportar pares arbitrários por muitos serviços e não é mecanismo de autorização; dados não confiáveis nesse campo nunca devem decidir privilégios [4].
Cardinalidade é o número de combinações distintas de valores dos labels de uma série. Uma métrica rotulada com 20 endpoints, 5 grupos de status e 3 regiões já pode produzir até 300 séries. Adicionar 1.000.000 de IDs de usuário pode multiplicar drasticamente essa quantidade. Prefira labels de domínio limitado para métricas; use logs restritos ou traces para IDs individuais quando forem realmente necessários.
Cálculo reproduzível do orçamento de erros#
Para SLO por requisições com meta S e N chamadas elegíveis, quantidade permitida de falhas é (1−S)×N dentro da janela. Se S=99,9% e N=10.000, o orçamento é 10 falhas. Se ocorrerem 25, o sistema consumiu 250% da margem nominal. Isso é consumo do orçamento, não prova de que cada falha produziu impacto idêntico. Alertas de burn rate comparam taxa observada de falhas com taxa admitida e ajudam a reconhecer consumo acelerado antes de terminar a janela [3].
from math import ceil

def percentil_rank(valores, fracao):
    if not valores or not 0 < fracao <= 1:
        raise ValueError("amostra e fracao invalidas")
    ordenados = sorted(valores)
    return ordenados[ceil(fracao * len(ordenados)) - 1]

def orcamento_erros(elegiveis, falhas, meta):
    if elegiveis <= 0 or not 0 <= falhas <= elegiveis or not 0 < meta < 1:
        raise ValueError("contagens ou meta invalidas")
    permitidas = elegiveis * (1 - meta)
    return {"permitidas": permitidas, "consumido": falhas / permitidas}

assert percentil_rank([10, 20, 25, 40, 100], 0.8) == 40
assert percentil_rank([10, 20, 25, 40, 100], 0.99) == 100
resultado = orcamento_erros(10000, 25, .999)
assert round(resultado["permitidas"]) == 10
assert round(resultado["consumido"], 2) == 2.50
A fórmula do rank mais próximo é uma convenção de percentil; outras formas de interpolação produzem respostas diferentes em amostras pequenas. A conta de SLO supõe pesos por contagem de requisições. SLO temporal ou com importância diferente por operação exige outra regra. Janelas curtas com poucas chamadas têm taxas instáveis e devem ser tratadas sem alarmes indiscriminados.
Amostragem e falhas invisíveis#
Registrar todos os traces de serviço muito movimentado pode custar rede e armazenamento excessivos. Head sampling decide antes da conclusão do trace e pode perder requisições raras, lentas ou malsucedidas. Tail sampling pode inspecionar traces completos, mas exige buffer e coordenação. Guardar um trace por mil requisições não permite concluir ausência de erros quando nenhum trace retido os contém. Métricas de erro devem vir de medição suficientemente confiável, não apenas de traces amostrados.
Collector, exporter e backend de telemetria também podem falhar ou descartar eventos. Monitore atraso de ingestão, spans perdidos, diferença entre relógios e saturação da fila de telemetria. Percentis calculados somente sobre traces sobreviventes podem parecer artificialmente bons em incidentes de sobrecarga.
Investigação de incidente passo a passo#
Suponha que a latência p99 suba de 120 ms para 900 ms após um deploy. Identifique operação, período e região afetados; separe erros de sucessos. Confira tráfego oferecido, profundidade de filas, CPU e dependências. Abra traces completos representativos para descobrir se o aumento está no banco, cache, conexão de rede ou lógica da aplicação. Compare versões antes/depois e mudanças simultâneas: coincidência temporal não comprova causalidade.
Se o aumento acompanha espera por locks do banco, investigue transações que seguram esses locks antes de aumentar número de réplicas web. Escalar a camada errada pode agravar contenção. Defina critério de rollback e teste se a versão anterior também recupera o comportamento medido.
Matriz de falhas e prática#
| Armadilha de diagnóstico | Por que falha | Evidência melhor |
|---|---|---|
| Média global de latência | Esconde caudas e grupos de erros | Histogramas por operação de cardinalidade limitada |
| Amostra sem erros | Amostragem pode perder falhas raras | Counters de erros e exemplos de traces |
| IDs em labels de métricas | Cardinalidade e custo excessivos | Labels limitados e IDs de trace em logs |
| Spans só com IDs locais | Perda da relação entre serviços | Propagação W3C |
| Dashboard sem definição SLO | Não indica impacto nem orçamento | População, janela e regra explícitas |
Leituras relacionadas: APIs confiáveis define deadlines e falhas; estimativa de capacidade trata medição sob saturação; redes apresenta orçamentos de conexão, TLS e HTTP.
Exercícios e verificação#
- Calcule orçamento de falhas para 50.000 chamadas elegíveis sob SLO 99,9%. Resposta: 50 falhas; defina o que conta como falha.
- Mostre como média de 50 ms pode coexistir com ao menos um valor de um segundo numa distribuição apropriada.
- Explique por que média dos p99 dos hosts não é p99 global.
- Desenhe trace com gateway HTTP, broker e consumidor; distinga relações pai-filho e links causais.
- Liste três campos inadequados ao baggage propagado globalmente e justifique com privacidade ou fronteira de confiança.