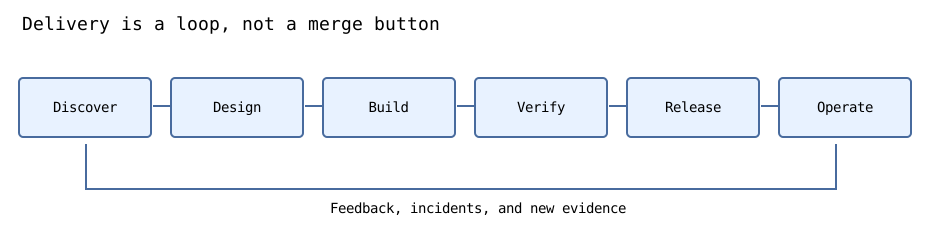
Um projeto de software não termina quando um pull request é mesclado. A responsabilidade de engenharia conecta descoberta, decisões, entrega, operação e aprendizado num ciclo verificável. Cada etapa produz evidência: descrição do problema, invariantes, decisão arquitetural, testes, registro de release e métricas operacionais. O fluxo é iterativo, não uma cascata obrigatória. Um defeito em produção pode alterar requisitos, enquanto um protótipo pode refutar a arquitetura antes da primeira publicação [1][2].
Comece pelo problema e por critérios de aceitação#
Imagine equipe que precisa fornecer exportação privada do histórico de pedidos de uma conta. O problema observado é que clientes não conseguem recuperar transações em formato legível por máquinas. Um ticket vago como “adicionar exportação CSV” omite limites e permissões. Uma boa definição do problema informa ator, resultado esperado, escopo dos dados, restrições e forma de verificar sucesso.
Um contrato específico poderia estabelecer: somente titular autenticado pede exportação dos próprios pedidos; o resultado fica disponível por 24 horas; as linhas são ordenadas por ID imutável; requisições concorrentes com mesma chave de operação geram um único trabalho lógico; outra conta não pode acessar arquivo. Retenção, auditoria e recuperação são requisitos do produto, não detalhes periféricos. Escolha conscientemente resposta síncrona ou aceite assíncrono.
Viabilidade, riscos e alternativas#
Antes de programar, enumere incertezas: tamanho máximo das contas, custo da consulta, classificação de dados pessoais, política de object storage e escaping de conteúdo fornecido pelo usuário para que planilhas não interpretem fórmulas indevidas. Faça benchmark pequeno sobre massa representativa e plano de execução real. Não extrapole throughput de um fixture minúsculo nem suponha exportação constante no tamanho do arquivo.
Compare duas opções. Exportação síncrona simplifica o cliente, mas ocupa workers HTTP e pode estourar deadlines. Exportação assíncrona cria trabalho durável e só armazena arquivo após processamento; exige máquina de estados, retentativas e limpeza. Decida por distribuição de tamanhos, metas de latência e experiência esperada. Registre hipóteses, consequências, reversibilidade e evidência que justificaria reconsiderar a escolha.
Divida o trabalho em entregas verticais testáveis#
Uma entrega vertical atravessa camadas necessárias a uma capacidade visível: autenticar solicitante, aceitar comando, persistir trabalho e expor status. Outra fatia gera arquivo e trata expiração. Isso fornece feedback antes de todos os subsistemas estarem completos. Especifique interfaces entre API, autoridade de jobs, armazenamento e notificações e declare quem protege cada invariante.
Evite planejamento que apenas enumera “criar banco, depois API, depois UI”, sem disponibilizar fluxo útil ponta a ponta. Também evite serviço independente para cada método. Um monólito modular pode ser suficiente inicialmente. Divida por resultados observáveis e premissas arriscadas, não por tecnologias na moda.
Modele transições explicitamente#
O trabalho de exportação possui estados requested, running, ready, failed e expired. O sistema não pode informar ready antes de existir arquivo durável com controle de acesso válido. Na versão simplificada, expirar é permitido após conclusão; cancelamento e recuperação de workers travados exigiriam transições adicionais na produção.
TRANSICOES = {
    "requested": {"running"},
    "running": {"ready", "failed"},
    "ready": {"expired"},
    "failed": set(),
    "expired": set(),
}

def avancar(estado, destino):
    if destino not in TRANSICOES.get(estado, set()):
        raise ValueError(f"transicao proibida: {estado} -> {destino}")
    return destino

trabalho = "requested"
trabalho = avancar(trabalho, "running")
trabalho = avancar(trabalho, "ready")
trabalho = avancar(trabalho, "expired")
assert trabalho == "expired"
for origem, destino in (("requested", "ready"), ("failed", "ready"),
                        ("expired", "running"), ("unknown", "running")):
    try:
        avancar(origem, destino)
        assert False
    except ValueError:
        pass
A função é verificação local de política, não mecanismo durável de concorrência. Dois workers podem ler requested e tentar começar simultaneamente. Compare-and-swap no banco por versão ou estado deve garantir exclusividade. Transições, persistência do objeto e eventos outbox são coordenados pela autoridade do trabalho. Retries precisam de identidades estáveis, e o vencimento de lease deve permitir recuperação.
Revisão de código e validação automatizada#
Implemente mudanças pequenas que mantenham o projeto executável. Code review deve examinar design, funcionalidade, complexidade, testes, nomes, comentários, documentação e integração; esses elementos estão nas diretrizes públicas de revisão do Google [1]. O revisor também verifica se uma exportação permite acessar dados de outra conta ou se conteúdo CSV pode disparar fórmulas ao abrir em planilha.
Valide por camadas: unit tests de estados e escaping CSV; autorização entre tenants; integração com banco e contrato real de armazenamento; teste ponta a ponta que solicita, gera e obtém arquivo; e injeção de falha quando worker cai após upload, mas antes de persistir status. Um mock de object storage não prova durabilidade e permissões reais.
Deploy mensurado de cada release#
O release candidate é artefato versionado vinculado a commit e dependências. Promova artefato revisado por gates automatizados, teste migração de esquema em dados representativos e publique com exposição controlada ou feature flag quando necessário. A flag pode bloquear novas exportações, mas não revoga arquivo já divulgado por permissão incorreta sem uma operação própria de limpeza.
Observe idade da fila, tamanho de arquivos, falhas de jobs, p95 de conclusão, acessos proibidos, consumo dos workers e backlog de expiração. Um SLO só faz sentido com denominador e janela especificados. HTTP 202 evidencia aceite do trabalho, não exportação concluída. O resultado de negócio deve ser medido separadamente da disponibilidade HTTP.
Incidentes, aprendizado e manutenção#
Quando uma exportação falha ou vaza dados, contenha o comportamento perigoso, preserve evidências, recupere serviço e produza postmortem sem busca de culpados, descrevendo linha do tempo, fatores contribuintes, falhas de detecção, impacto e ações priorizadas [2]. Isso não elimina responsabilidade: cada ação precisa de dono e validação. Evite concluir apenas que “o desenvolvedor deveria prestar mais atenção”; corrija mecanismos que deixaram o defeito passar.
Manutenção inclui atualização de dependências, revisão de vulnerabilidades, auditoria de retenção, otimizações por medidas e retirada de flags obsoletas. Acompanhe trabalho repetitivo operacional e consumo do orçamento de erros. O ciclo fecha quando incidentes e uso real alteram a próxima rodada de requisitos.
Matriz de decisões e falhas#
| Etapa | Evidência registrada | Antipadrão |
|---|---|---|
| Descoberta | Ator, problema e critério verificável | Ticket sem definição de sucesso |
| Design | Invariantes, opções e justificativa | Arquitetura antes de analisar carga |
| Implementação | Fatias verticais coesas | Mudança gigantesca sem revisão |
| Revisão e testes | Casos reproduzíveis e segurança | Mock como única prova externa |
| Publicação | Artefato, estratégia de deploy e rollback | Recompilar dependências variáveis |
| Operação | SLI/SLO, alertas e incidentes | Medir somente HTTP bem-sucedido |
A equipe pode usar iterações ágeis, marcos graduais ou outros processos; o nome do processo não substitui aceitação verificável e responsabilidade. A análise mais útil acompanha um requisito do usuário até design, código, testes, release e resultado observado.
Exercícios e verificação#
- Escreva três testes de aceitação para exportação, incluindo negação de acesso entre tenants.
- Por que o verificador de estados não impede dois workers independentes de reivindicarem o mesmo trabalho?
- Escolha exportação síncrona ou assíncrona para uma conta com dez milhões de pedidos; indique medidas que alterariam a escolha.
- Desenhe teste de falha após upload, mas antes de persistir
ready. - Defina métricas e ações de postmortem que demonstram confiabilidade do recurso após publicação.
Capítulos relacionados: Estratégias de testes, CI/CD e releases, fronteiras de serviço e resposta a incidentes detalham as técnicas.