Um feed inicial combina conteúdo de vários autores numa visão ordenada para o leitor. Parece simples, mas é caro porque uma publicação pode alcançar milhões de seguidores, enquanto certos usuários atualizam o feed muitas vezes sem publicar. A principal decisão é quando reunir candidatos: no momento da escrita, na consulta ou numa combinação híbrida. Nenhum extremo garante custo baixo para todas as distribuições de seguidores. Este capítulo projeta um feed cronológico hipotético, sem afirmar como uma empresa específica o implementa atualmente [1][2].
Requisitos funcionais, exclusões e privacidade#
Suponha usuários publicando texto, seguindo/deixando de seguir contas e consultando feed inicial em ordem cronológica inversa. Usuário pode excluir sua postagem ou bloquear leitor. A primeira versão suporta ordenação cronológica, não personalização por aprendizado de máquina, anúncios, comentários ou recomendações fora da rede seguida. Paginação é limitada e estável em empates. Publicação aceita exige registro durável; a presença no feed de todos os seguidores pode ocorrer com atraso documentado.
Privacidade e autorização são requisitos, não otimizações de cache. Uma entrada de timeline é somente candidata: antes de devolver conteúdo, confira se a postagem existe, se o leitor pode ver o autor e se políticas de bloqueio/exclusão permitem. Um unfollow pode competir com fanout já realizado; a leitura precisa filtrar candidatos obsoletos, não confiar cegamente no cache antigo.
Hipóteses de volume de leitura e escrita#
Considere 100 mil postagens/dia, 20 milhões de consultas de feed/dia e pico hipotético dez vezes maior que média para ambos. A taxa média de postagens é cerca de 1,16/s; leituras de feed são 231,5/s em média e cerca de 2.315/s no pico. Se cada postagem é materializada em 250 caixas de seguidores em média, fanout somente de escrita gera 25 milhões de entradas/dia, média de 289 escritas/s e potencialmente 2.894/s sob o mesmo multiplicador hipotético.
Suponha que cada ponteiro materializado, índice e metadados representam 200 bytes lógicos. Isso equivale a 5 GB de novos ponteiros/dia ou cerca de 1,83 TB/ano antes de replicação, backups, overhead de índices e limpeza por retenção. São números do cenário, não métricas de plataforma real. A média engana: autor com cinco milhões de seguidores produz cinco milhões de escritas a partir de um único post, independentemente do fanout médio.
Fanout na leitura, escrita ou híbrido#
Fanout on read armazena linha do tempo autoritativa do autor e, quando usuário U pede feed, consulta postagens recentes de cada conta seguida e mescla listas. A escrita é barata e alterações de follow/unfollow refletem naturalmente se a rede está atualizada. Mas usuários que seguem muitos autores podem provocar centenas de consultas remotas por atualização.
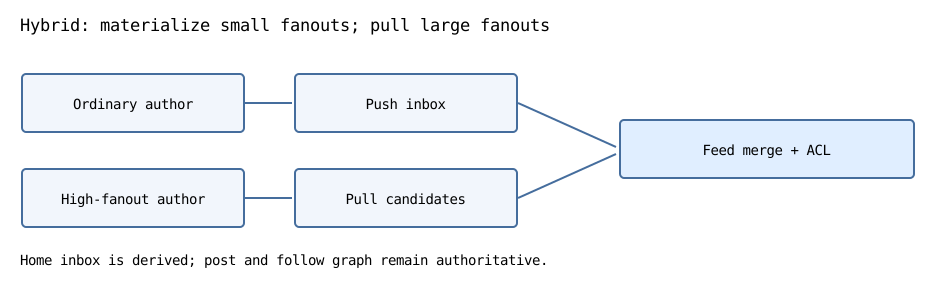
Fanout on write grava o ID de cada publicação na timeline materializada de cada seguidor. O leitor realiza basicamente uma busca indexada dos IDs e carrega corpos dos posts. O custo é amplificação de escrita, referências obsoletas, recuperação após crashes e rajadas massivas de autores populares. A timeline pré-computada é índice derivado, não autoridade de existência ou visibilidade.
O modelo híbrido faz push para autores comuns e pull durante leitura para autores cujo alcance torne fanout caro. O limiar depende de seguidores ativos medidos, frequência de escrita, leitura, orçamento de latência e custos, não de rótulo arbitrário como 'celebridade'. Ele equilibra custos médios, mas adiciona complexidade de merge, consistência e privacidade.
APIs, dados autoritativos e índices#
Um contrato proposto inclui POST /v1/posts (201 somente após commit durável), POST /v1/follows/{author}, DELETE /v1/follows/{author} e GET /v1/feed?limit=20&cursor=.... Propriedade vem da identidade autenticada, não de autor informado pelo cliente. Defina se postagens privadas entram em índices e quão rapidamente bloqueios/exclusões se tornam efetivos.
O modelo mínimo contém Post(post_id,author_id,created_at,body,deleted_at), Follow(follower_id,followee_id), AuthorTimeline(author_id,created_at,post_id) e HomeCandidate(viewer_id,created_at,post_id). Ordenação estável usa (created_at DESC,post_id DESC). Paginação keyset exige chave composta estritamente inferior ao último item exibido. Cursor não é autorização; toda página deve validar acesso.
Post e Follow autoritativos são separados do HomeCandidate pré-calculado. Outbox durável ou stream de mudanças publica ID para reconstruir timelines após falha. Mensagens duplicadas são esperadas: uma chave única (viewer_id,post_id) permite fanout idempotente sob entrega pelo menos uma vez.
Modelo híbrido executável#
O código cria inboxes de push para autores com menos de três seguidores e mescla candidatos pull de autores maiores. Executa apenas em memória, supõe todas as postagens públicas e faz varreduras completas para deixar a semântica explícita; sistemas reais precisam de índices, limites e checagens de privacidade.
def construir_caixas(postagens, seguidores, limite_push):
    caixas = {}
    for instante, id_post, autor in postagens:
        leitores = seguidores.get(autor, set())
        if len(leitores) < limite_push:
            for leitor in leitores:
                caixas.setdefault(leitor, []).append((instante, id_post, autor))
    return caixas

def pagina_feed(usuario, seguindo, seguidores, postagens, caixas, limite_push,
                tamanho, cursor=None):
    if tamanho <= 0:
        raise ValueError("tamanho positivo obrigatorio")
    autores = seguindo.get(usuario, set())
    candidatos = list(caixas.get(usuario, ()))
    for item in postagens:
        if item[2] in autores and len(seguidores.get(item[2], set())) >= limite_push:
            candidatos.append(item)
    sem_duplicatas = {item[1]: item for item in candidatos if item[2] in autores}
    ordenadas = sorted(sem_duplicatas.values(), key=lambda p: (p[0], p[1]),
                      reverse=True)
    if cursor is not None:
        ordenadas = [p for p in ordenadas if (p[0], p[1]) < cursor]
    pagina = ordenadas[:tamanho]
    proximo = (pagina[-1][0], pagina[-1][1]) if pagina else None
    return [p[1] for p in pagina], proximo

seguidores = {"alice": {"bob", "carol"},
              "star": {"bob", "carol", "dave", "erin"}}
postagens = [(104,4,"alice"),(103,3,"star"),(102,2,"alice"),(101,1,"star")]
caixas = construir_caixas(postagens, seguidores, limite_push=3)
seguindo = {"bob": {"alice", "star"}}
p1, cursor = pagina_feed("bob", seguindo, seguidores, postagens, caixas, 3, 2)
p2, _ = pagina_feed("bob", seguindo, seguidores, postagens, caixas, 3, 2, cursor)
assert p1 == [4, 3] and p2 == [2, 1]
assert len(caixas["bob"]) == 2
seguindo["bob"] = {"alice"}
assert pagina_feed("bob", seguindo, seguidores, postagens, caixas, 3, 5)[0] == [4, 2]
O desempate é post_id, considerado único. A demonstração não tem persistência, cancelamento, ranking nem índice otimizado. Ela mostra que unfollow filtra candidatos na leitura, mesmo que ponteiros antigos permaneçam materializados. Exclusões, bloqueios e contas privadas exigem filtros adicionais na hidratação; a API real não deve confiar num mapa seguindo se ele não vier de autoridade autenticada.
Caminho de leitura e ranking opcional#
Um fluxo prático é: autenticar leitor → recuperar IDs materializados → buscar posts recentes dos autores seguidos com fanout alto → mesclar/remover duplicatas → filtrar visibilidade e exclusão → opcionalmente ranquear → carregar corpos/mídia → emitir página limitada. Coloque cache em gargalos medidos, sem pular verificações de bloqueio. Carregue corpos em lote; uma consulta por postagem causa amplificação N+1 de chamadas remotas.
Para feed ranqueado em vez de cronológico, defina o contrato de ranking: sinais permitidos, necessidade de snapshot, frescor e exclusões explicáveis. A classificação pode mudar entre páginas e invalidar cursor cronológico simples. Feed ranqueado pode exigir snapshot estável de sessão, versão de ranking ou paginação explicitamente aproximada.
Backpressure, exclusão e recuperação#
Workers de fanout consumindo fila durável podem cair depois de gravar alguns seguidores e antes de confirmar evento. Reexecução deve usar upsert por (leitor,post_id) para não duplicar candidatos. Se autor de alcance massivo provoca backlog, fila não é buffer infinito: admissão limitada, justiça entre prioridades, idade máxima monitorada e capacidade de recuperação protegem latência útil [2].
Excluir Post autoritativo deve tornar seu corpo invisível imediatamente segundo a meta de consistência acordada; IDs obsoletos em inbox podem ser filtrados e limpos depois. Leitor bloqueado não pode receber conteúdo privado porque um pipeline ignorou alteração. Se mudança de seguidores compete com fanout, reconcilie ou filtre pela relação de autorização atual.
| Falha ou trade-off | Mitigação | Risco restante |
|---|---|---|
| Autor popular gera milhões de pushes | Pull desse autor no read path | Custo do merge |
| Worker repete publicação | Chave única leitor/post | Atraso de backfill |
| Usuário deixa de seguir após push | Filtrar rede atual no read | Mais trabalho por página |
| Post apagado ainda no cache | Checar visibilidade e invalidar | Cache velho antes da limpeza |
| Leitor segue milhares de contas | Consulta limitada e precomputação seletiva | Scatter/gather |
| Ranking muda entre páginas | Snapshot/versão de sessão | Custo e complexidade |
Verificação e métricas operacionais#
Teste merge e paginação sob timestamps iguais, eventos duplicados, postagens excluídas e corridas de unfollow/bloqueio. Meça atraso post→visível em p50/p95/p99, escritas materializadas por postagem, latência de candidatos, assimetria de fanout, idade de fila, taxa de duplicatas de página, cache hit e incidentes de acesso indevido. Desligue um worker no meio do fanout e confirme que replay repara entradas faltantes sem duplicação.
Exercícios e verificação#
- Deduza 25 milhões de pushes/dia e 1,83 TB/ano, declarando unidades e hipóteses.
- Por que uma conta com milhões de seguidores invalida dimensionamento baseado só na média?
- Demonstre por que ordenação e cursor exclusivo evitam duplicação com dados cronológicos imutáveis e IDs únicos.
- Implemente filtro que remove posts excluídos e autores bloqueados antes de devolver corpos.
- Compare custos de push, pull e híbrido para leitor que segue 2 mil contas, uma com dez milhões de seguidores.
Capítulos relacionados: Método de System Design, sharding, mensageria, cache e paginação dão suporte.