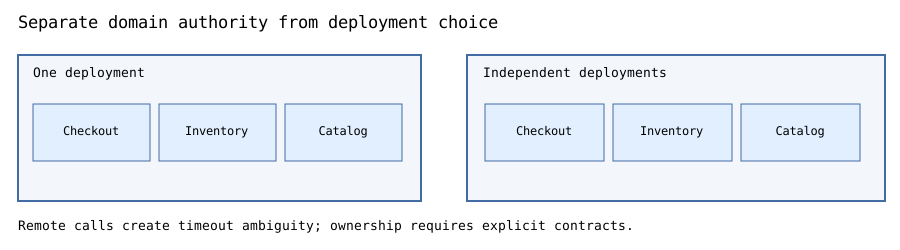
Uma fronteira de serviço define qual componente controla uma decisão de negócio, seu estado durável e seu contrato de falhas. Não é sinônimo de endereço de rede. Um monólito modular pode separar pedidos, estoque e pagamentos por interfaces pequenas no mesmo processo; serviços independentes acrescentam latência de rede, falha parcial, autorização, telemetria e consistência distribuída. Escolha a menor fronteira de implantação que resolve problema mensurável, não um número arbitrário de microsserviços [1].
Comece por capacidades e invariantes#
Considere sistema com catálogo, checkout, reserva de estoque e autorização de pagamento. Descrições de produtos podem ficar desatualizadas brevemente, mas estoque disponível não pode ficar negativo após reserva confirmada. Esse invariante define uma autoridade de estoque. Checkout solicita reservas, mas, se cada domínio usa banco separado, uma transação ACID local não abrange os dois. A escolha da fronteira altera, portanto, o argumento de correção.
Mapeie capacidades: catálogo controla descrições; estoque possui unidades disponíveis e reservadas; checkout controla identidade e ciclo de vida dos pedidos; integração de pagamento controla referências ao provedor. Defina quem altera cada dado e se os demais consultam API, recebem evento ou leem uma projeção. Escrever diretamente na tabela privada de outro domínio destrói a propriedade, mesmo com serviços em containers separados.
Monólito modular como base#
Num monólito modular, pacotes respeitam interfaces de domínio e uma única unidade executável organiza o processo. Um banco pode suportar transações locais sobre tabelas de pedido e estoque quando necessário, e chamadas de função evitam ambiguidades de timeout de rede. Módulos são testáveis separadamente quando não importam tabelas internas, classes privadas ou globals mutáveis uns dos outros. Uma API interna já é útil antes de extrair serviços [1].
Monólito não significa arquivo gigantesco e desorganizado. Por outro lado, dividir aplicação acoplada em containers pode criar monólito distribuído: equipes sincronizam deploys e falhas se propagam por toda a cadeia. A extração se justifica por escalabilidade independente, responsabilidades de equipes, isolamento regulatório, cadência de entrega ou contenção de falhas quando o custo de rede e consistência é aceitável.
Chamadas síncronas e falhas parciais#
Uma chamada síncrona do checkout ao estoque parece simples: reservar(sku,quantidade) responde sucesso ou erro. Após timeout, porém, checkout não sabe se a reserva foi confirmada e apenas a resposta se perdeu. Repetir sem identidade de operação pode reservar duas vezes. Use chave idempotente estável por escopo e persista resultado na autoridade de estoque.
Cadeias RPC aumentam modos de falha. Se quatro dependências independentes precisam estar disponíveis e cada uma funciona com probabilidade 0,999 no intervalo, a chance conjunta é 0,999⁴ ≈ 99,60%. É um modelo simplificado de independência, não previsão de disponibilidade real. Falhas correlacionadas, cache, fallback, retries, volume e topologia mudam o resultado. Da mesma forma, somar p95 de cada salto não fornece o p95 fim a fim.
def sucesso_cadeia_independente(probabilidades):
    if any(not 0 <= p <= 1 for p in probabilidades):
        raise ValueError("probabilidade invalida")
    resultado = 1.0
    for p in probabilidades:
        resultado *= p
    return resultado

assert round(sucesso_cadeia_independente([0.999] * 4) * 100, 2) == 99.60
assert sucesso_cadeia_independente([]) == 1.0
assert sucesso_cadeia_independente([1, 0.5]) == 0.5
try:
    sucesso_cadeia_independente([1.2])
    assert False
except ValueError:
    pass
O produto de probabilidades só é válido dentro da independência assumida. Não o transforme em fórmula automática de dimensionamento de microsserviços. Meça jornadas reais e dependências antes de estabelecer SLOs.
Colaboração assíncrona e outbox#
Um fluxo assíncrono pode persistir pedido e evento outbox numa única transação. Um relay publica o evento depois, e workers de estoque ou pagamento o processam. Isso reduz espera síncrona, mas a conclusão é eventual: cliente consulta estado pendente enquanto trabalha em segundo plano. Broker pode entregar mensagem novamente; consumidor precisa deduplicar por identidade durável [2].
Entrega de eventos não cria atomicidade entre serviços. Se pedido e estoque possuem bancos independentes, use protocolo semelhante a saga, estados explícitos, deadlines e compensações. Liberar reserva por falha de pagamento é operação nova, não rollback de cobrança externa. Timeout no provedor de pagamento deixa resultado incerto; é preciso reconciliar antes de presumir sucesso ou falha.
Fronteiras seguem a consistência#
Uma boa separação minimiza invariantes distribuídos entre autoridades. Mantenha quantidades de estoque e ledger de reservas sob um dono, mesmo que outros recebam InventoryReserved. Busca do catálogo pode exibir disponibilidade estimada, mas não autorizar venda. Regra de unicidade global exige registro autoritativo conhecido, não índices únicos desconectados em serviços diferentes.
Quando consumidores precisam de consistência imediata entre entidades, separar cedo demais costuma exigir transação distribuída ou reformulação. Em contrapartida, projeção de leitura tolerante a atraso pode ser replicada assincronamente e escalada à parte. Anote por API: leitura de commit forte, read-your-writes, consistência eventual ou staleness limitada.
Evolução sem reescrita integral#
Migração gradual pode manter a aplicação antiga como autoridade enquanto uma capacidade passa a ser acessada por adaptador. Primeiro isole interfaces internas, meça chamadas, estabeleça donos e remova acessos diretos a tabelas. Crie serviço atrás do adaptador, faça backfill, capture mudanças e compare resultados. Desvie tráfego em etapas controladas, observe erro e latência e mantenha plano de rollback [1].
Dual writes para bancos antigo e novo não são automaticamente seguros: cair após um commit deixa estados divergentes. Preserve fonte da verdade durante migração, reproduza mudanças com versões estáveis e bloqueie escrita obsoleta na troca. Mudanças de esquema incompatíveis também podem impedir rollback de código.
Latência, falhas e custos operacionais#
| Opção | Quando ajuda | Custo oculto |
|---|---|---|
| Módulo num monólito | Mesma transação e equipe pequena | Falha/deploy do processo compartilhado |
| API síncrona | Resposta imediata necessária | Timeout e resultado incerto |
| Outbox com eventos | Conclusão pode acontecer depois | Atraso, duplicatas e replay |
| Serviço separado | Escala/equipes/isolamento autônomos | Operação, versões e propriedade |
| Escrita cruzada em banco compartilhado | Só em transição legada controlada | Acoplamento de contratos e dados |
Além de CPU e armazenamento, conte autenticação entre serviços, segredos, tracing, incidentes, pipelines e plantões. Quatro serviços que precisam de alterações coordenadas podem custar mais que módulo bem estruturado. Extração não garante manutenção mais simples.
Exercícios e verificação#
- Descreva o invariante de estoque e por que cache de catálogo atualizado eventualmente não consegue garanti-lo.
- Trace timeout depois do commit da reserva e demonstre como chave idempotente durável permite retry.
- Recalcule sucesso simplificado de três dependências a 99% cada; apresente duas razões para não prever SLO real.
- Proponha extração gradual do catálogo que mantenha uma autoridade única em cada etapa.
- Compare chamada síncrona ao estoque e evento outbox em latência, correção, retries e recuperação.
Capítulos relacionados: Método de System Design, pedidos, mensageria e APIs confiáveis aprofundam as técnicas [1][2].